Verslag
Titels:
Project 1: Gates and wires
Project 2: Adders
Project 3: ALU
Algemeen besluit van onze 3 projecten
Project 4: Memory
Project 5: Datapath
Algemeen besluit van onze 5 projecten
Project 6: Full Datapath
Project 7: Datapath in use
Algemeen besluit van onze 7 projecten
Dit verslag werd opgesteld door:
- Naam: Vladomeare Obolonskyy
Studentennummer: 20190391
Email adres: vladomeare.obolonskyy@student.uantwerpen.be
- Naam: Hans Van Kerckhoven
Studentennummer: 20187280
Email adres: hans.vankerckhoven@student.uantwerpen.be
Aantal man-uren besteed: 40-50 uur
Moeilijkheidsgraad: 3 /10 (1 is heel makkelijk, 10 is heel moeilijk)
Inhoud van de oplossing
De oplossing bestaat uit de volgende bestanden:
Archief:
Groep02_verslag.tar.xz
Groep02_verslag.zip
Verslag
Project 1: Gates and wires
Dit is het eerste deel van ons project. Hier gaan we eerst heel kort kennis maken met propositielogica om die daarna verder te gebruiken in de bouw van onze schema's. Daarna gaan we even uitwijken naar de bouw van de NAND-poort en de daarop volgende terugschakeling naar de basispoorten. Met onze kennis van propositielogica gaan we dan een schema maken die de nodige waarheidstabel implementeert. Met de opgedane kennis zullen we dan in staat zijn om een decoder te implementeren voor een 7-segment display.
Oefening 1: Bewijzen van de wetten van De Morgan via een waarheidstabel
Een zeer simpele oefening waar we twee waarheidstabellen voor elke uitdrukking apart opmaken, waarna we controleren of zij hetzelfde opleveren.
a)
| A |
B |
A+B |
A+B |
| 0 |
0 |
0 |
1 |
| 0 |
1 |
1 |
0 |
| 1 |
0 |
1 |
0 |
| 1 |
1 |
1 |
0 |
|
| A |
B |
A |
B |
A·B |
| 0 |
0 |
1 |
1 |
1 |
| 0 |
1 |
1 |
0 |
0 |
| 1 |
0 |
0 |
1 |
0 |
| 1 |
1 |
0 |
0 |
0 |
|
We kunnen hierbij opmerken dat de laatste kolommen van de twee tabellen gelijk zijn. Dit bewijst de uitdrukking A+B = A·B .
b)
| A |
B |
A·B |
A·B |
| 0 |
0 |
0 |
1 |
| 0 |
1 |
0 |
1 |
| 1 |
0 |
0 |
1 |
| 1 |
1 |
1 |
0 |
|
| A |
B |
A |
B |
A+B |
| 0 |
0 |
1 |
1 |
1 |
| 0 |
1 |
1 |
0 |
1 |
| 1 |
0 |
0 |
1 |
1 |
| 1 |
1 |
0 |
0 |
0 |
|
We kunnen hierbij opmerken dat de laatste kolommen van de twee tabellen gelijk zijn. Dit bewijst de uitdrukking A·B = A+B .
Oefening 2: Bewijs van een gegeven booleaanse expressie
Door gebruik te maken van basiswetten van booleaanse algebra:
((A·B)+(A·C)+(B·C))·(A·B·C) =
= ((A·B)+(A·C)+(B·C))·(A+B+C) = //Gebruik makend van wet (b) van De Morgan in een variant voor 3 variabelen. Wiskundig is dat een triviaal bewijs.
= A·A·B + A·B·B + A·B·C + A·A·C + A·B·C + A·C·C + A·B·C + B·B·C + B·C·C = // Distibutiviteitswet, ook zeer triviaal om aan te tonen dat deze voor meerdere variabelen ook geldt. Hierbij is ook direct gebruik gemaakt van de commutativiteitswet voor makkelijker inzicht.
= 0·B + A·0 + A·B·C + 0·C + A·B·C + 0·A + A·B·C + 0·C + B·0 = // Complementswet toegepast
= A·B·C + A·B·C + A·B·C // 0 is absorberend element voor · en neutraal element voor + .
Oefening 3: NAND als basisschakeling
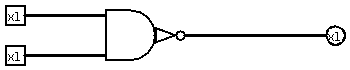
NAND is een logische schakeling die het tegenovergestelde resultaat van een AND geeft. Hieruit volgt de logische opbouw van deze schakeling uit de twee basisschakelingen AND en NOT, in serie geschakeld zoals op onderstaande schets.
Verder gaan we gebruik maken van volgende symbolische notatie:
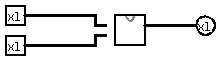
Het eerste waar we aan dachten is het omkeren van het signaal. Het is namelijk zo dat we een signaal makkelijk kunnen splitsen. Daarom implementeren we eerst de NOT door eenzelfde signaal op de twee ingangen te sturen. Op deze manier wordt de AND als een geleider van het signaal gebruikt (zoals een draad). We krijgen volgend schema:
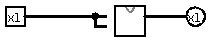
De volgende schakeling die we gaan implementeren is de AND omdat die ook in de basis van NAND ligt. Hiervoor gaan we van achter naar voor redeneren. We hebben zeker een NAND-poort waar de output uit moet komen. We weten zeker dat het uitgangssignaal 1 wordt als er bij minstens 1 van haar ingangen geen signaal toekomt. Dat betekent dat we voor elke ingang het signaal moeten omkeren. Het eerste wat er in het hoofd komt is natuurlijk de uitgang van een NAND-poort te gebruiken. Voor de zekerheid plaatsen we de twee aparte NANDs en verbinden we de twee verschillende signalen met beiden. We krijgen het volgende schema:
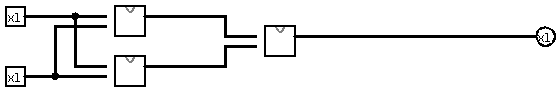
Nu kunnen we opmerken dat twee NAND poorten altijd dezelfde signalen gaan teruggeven want hun inputs zijn hetzelfde. Daarom mogen we die vervangen door 1 poort. Hoe we het signaal moeten omkeren hebben we al gezien bij NOT poort, dus passen we dat ook toe. Onze schema wordt nu:
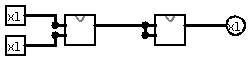
De laatste basisschakeling die we moesten implementeren is de OR-poort. Net zoals bij AND-poort werken we van achter naar voor. Als de laatste schakeling een NAND is, hebben we een outputsignaal zolang haar ingangen niet allebei 1 zijn. We hebben dus het omgekeerde van de inputsignalen nodig. Implementeren we twee NOT poorten, 1 voor elke input en sluiten we die aan aan de NAND poort, dan krijgen we de OR, zoals op volgende schema:
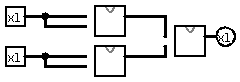
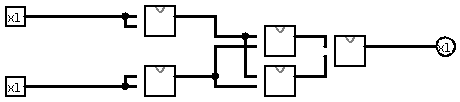
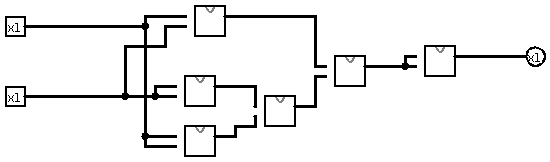
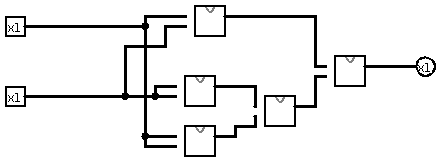
Op een gelijkaardige manier hebben we dan NOR, XOR en XNOR geimplementeerd. De schema's worden gegeven zonder uitleg. Deze werden geimplementeerd voor de fun, omdat we nerds wiskundigen zijn.
NOR:
XOR:
XNOR:
Oefening 4: Implementatie van een gegeven waarheidstabel
Om deze oefening op te lossen maken we gebruik van Karnaugh maps voor meerdere resultaten. Dat gebeurt op dezelfde manier als voor 1 resulterende kolom meerdere malen toe te passen en de algemene uitdrukkingen worden dan samengenomen voor de meerdere outputs.
De karnaugh map voor X zit er als volgt uit:
| |
B |
B |
B |
B |
| A |
0 |
0 |
1 |
0 |
| A |
0 |
0 |
1 |
1 |
| |
C |
C |
C |
C |
E1 = B·C + A·B
Voor Y krijgen we dan:
| |
B |
B |
B |
B |
| A |
0 |
1 |
1 |
0 |
| A |
0 |
1 |
1 |
1 |
| |
C |
C |
C |
C |
E2 = C + A·B
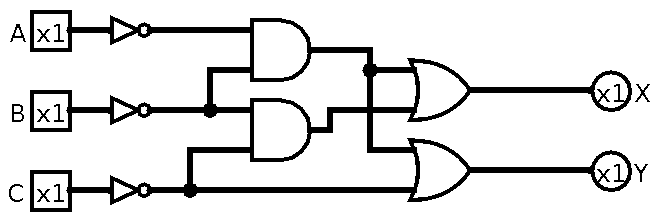
We zien dat A·B zowel in E1 als E2 voorkomt dus zal dit onze algemene term (AND-poort) zijn. Baserend op E1 en E2 krijgen we volgend schema:
Oefening 5: LED-display voor nummers 0-7
Hier zullen we een decoder maken voor een 7-segment display maken en die aansluiten. Omdat we bij het begin geen rekening hebben gehouden met effectieve nummering van de 7-segment display, is onze implementatie van de decoder gemaakt met eigen nummering en daarna hebben we de outputs herschikt zodat die beter overeenkomen met effectieve outputs. Hiervoor is er een kleine legende opgemaakt.
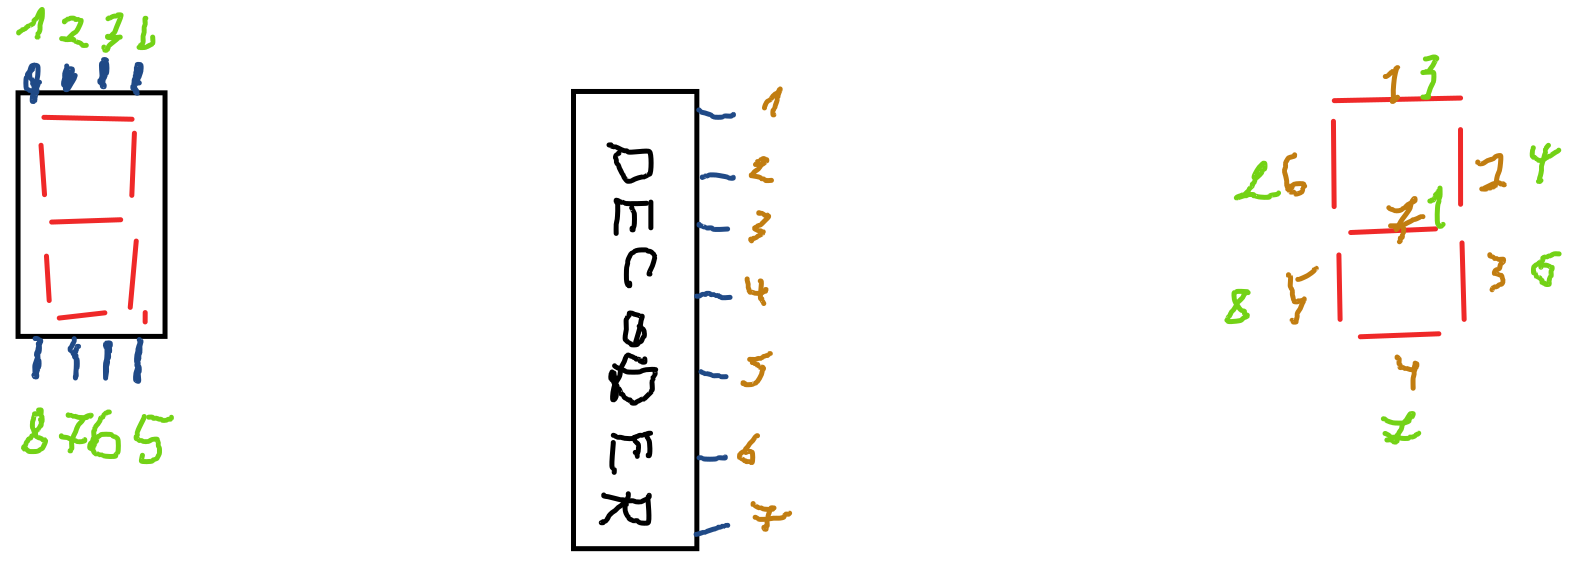
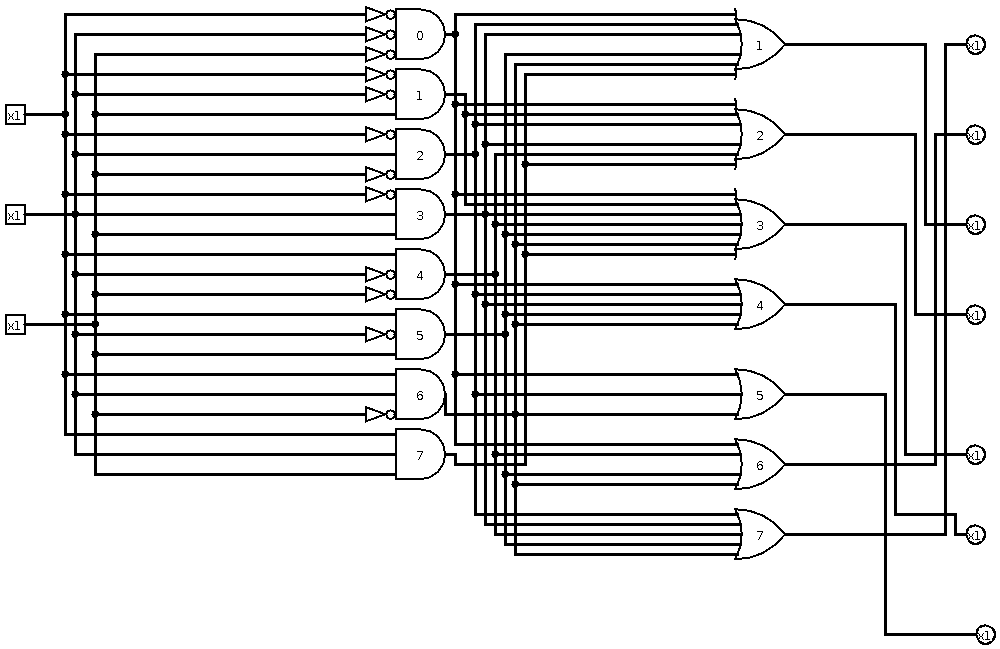
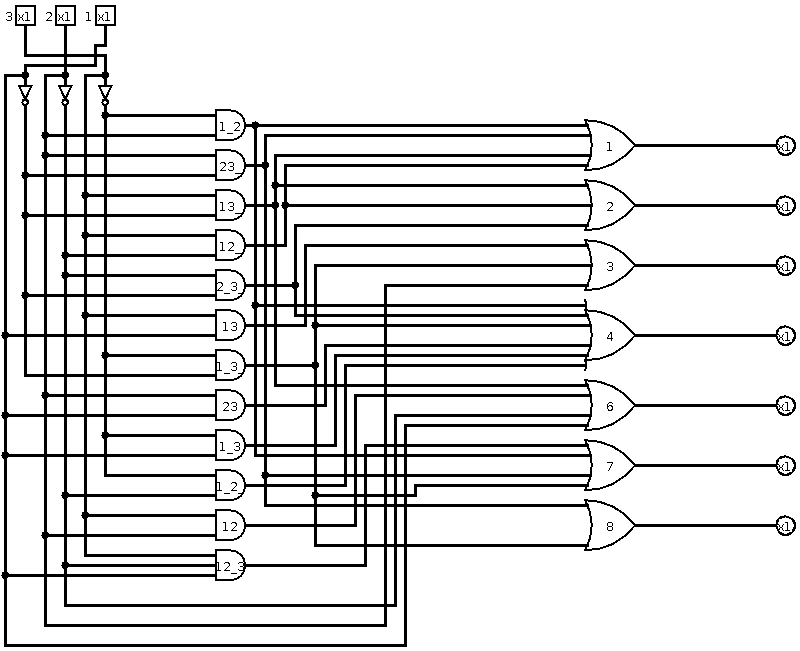
Nu we dit kennen, kunnen we uitleggen hoe onze decoder werkt. We hebben twee implementaties gemaakt, de eerste met behulp van een waarheidstabel en de tweede hebben we verbeterd met behulp van Karnaugh maps. De implementatie via waarheidstabel heeft 8 AND poorten en 7 OR poorten. De reactietijd bedraagt voor onze decoder 2ε. Het schema is hieronder gegeven:
Bekijken we nu de uiteindelijke implementatie van onze decoder door vereenvoudiging met Karnaugh maps. Die heeft meer AND poorten maar minder inputs op de poorten. We maken ook gebruik van 2 "kolommen" van poorten, dus onze reactietijd is weer 2ε zoals in vorig schema. De schetsen van expressies en berekeningen zijn toegevoegd als bijlagen. Het schema wordt:
Nu is de vraag, had het wel zin om het schema te verbeteren? Het laatste schema is precies net iets ingewikkelder geworden, omdat er meer poorten in zitten. Om op deze vraag een antwoord te geven, moeten we een factor bedenken die we kunnen vergelijken. Uit theorie weten we dat AND en OR poorten per input 1 transistor nodig hebben. Omdat die het meeste kosten, gaan we onze vergelijking hierop baseren. De weerstanden en NOT poorten zijn verwaarloosbaar hierbij.
Wat krijgen we dan voor ons eerste schema? Bij AND poorten hebben we 7 * 3 inputs = 21 inputs en voor OR poorten 6 + 6 + 7 + 5 + 3 + 4 + 5 = 36 inputs. In totaal dus 57 inputs, dus 57 transistoren nodig. Kijken we eens naar het tweede schema.
Hier hebben we 11 * 2 inputs + 3 inputs = 25 inputs. Dat is nog in het voordeel van ons makkelijkere schema. Kijken we dan nog naar de OR-gates, dan zien we 4 + 3 + 3 + 6 + 4 + 4 + 2 = 26 inputs. In totaal hebben we slechts 51 transistoren nodig.
Wat kunnen we uit bovenstaande concluderen? Het bespaarde materiaal in het tweede schema compenseert de moeilijkheid. Als we deze decoder maar 1 keer zouden maken zou het misschien niet veel verschil uitmaken, maar bij massaproductie is de vermindering in materiaal substantieel.
Project 2: Adders
Deze projectopgaven hielpen ons de binnenste werkingen van adders te kennen. Van de constructie van een 1-bit adder tot de serieschakeling van deze adders om een 16-bit ripple carry adder te maken tot een efficientere 16-bit carry lookahead adder, leerden we hoe we de booleaanse algebra achter de carry's konden implementeren in Logisim. We begonnen uiteraard met de 1-bit full adder.
Oefening 1: Een 1-bit full adder bouwen
We begonnen met een eenvoudige redenering van de optelling, begeleid door de opgaven.
a)
Als we 2 bits met elkaar willen optellen, zijn dit 2 inputs. Een carry-in input zullen we ook toevoegen zodat we dit logische circuit als module kunnen gebruiken voor de optelling van meerdere bits. de output zal uit 1 bit bestaan, maar het is duidelijk dat dit niet alle mogelijkheden dekt. Daarom voegen we ook een carry-out output bit toe, voor de overflow. Hieronder geven we een waarheidstabel voor alle mogelijkheden.
| A |
B |
C |
Y |
X |
| 0 |
0 |
0 |
0 |
0 |
| 0 |
0 |
1 |
0 |
1 |
| 0 |
1 |
0 |
0 |
1 |
| 0 |
1 |
1 |
1 |
0 |
| 1 |
0 |
0 |
0 |
1 |
| 1 |
0 |
1 |
1 |
0 |
| 1 |
1 |
0 |
1 |
0 |
| 1 |
1 |
1 |
1 |
1 |
b) Als we deze waarheidstabel omzetten naar twee Karnaugh maps, krijgen we dit:
| Y |
B |
B |
B |
B |
| A |
1 |
1 |
0 |
1 |
| A |
1 |
0 |
0 |
0 |
| |
C |
C |
C |
C |
|
| X |
B |
B |
B |
B |
| A |
1 |
0 |
1 |
0 |
| A |
0 |
1 |
0 |
1 |
| |
C |
C |
C |
C |
|
Y = AB + AC + BC
X = A·B·C + A·B·C + A·B·C + A·B·C
c) Deze vorm van booleaanse expressies kunnen we meteen implementeren in Logisim, als volgt:
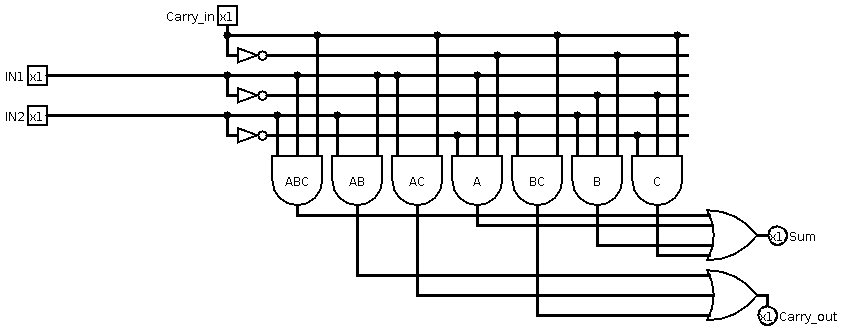
Oefening 2: Opbouw van een 16-bit ripple carry adder
a) Triviale oefening
b) De implementatie van deze 16-bit adder werd ons vergemakkelijkt door de 1-bit adder schakelingen die we nu konden invoegen. De enige vraag die we ons hierbij stelden was hoe we de layout gingen maken, dit was ons meest compacte model:
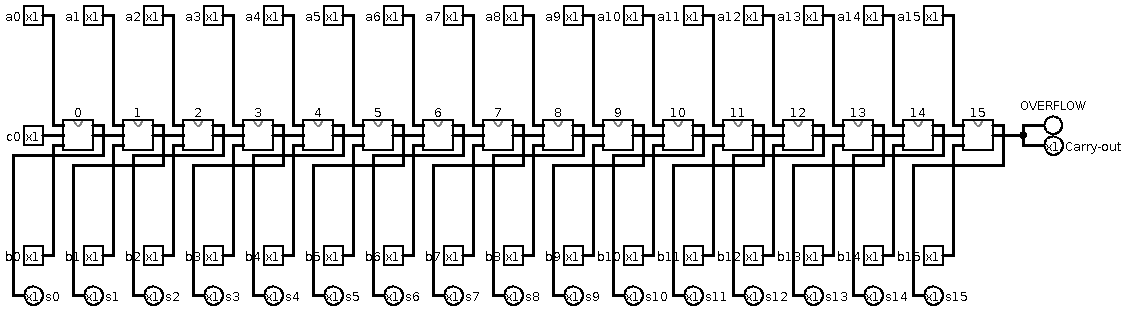
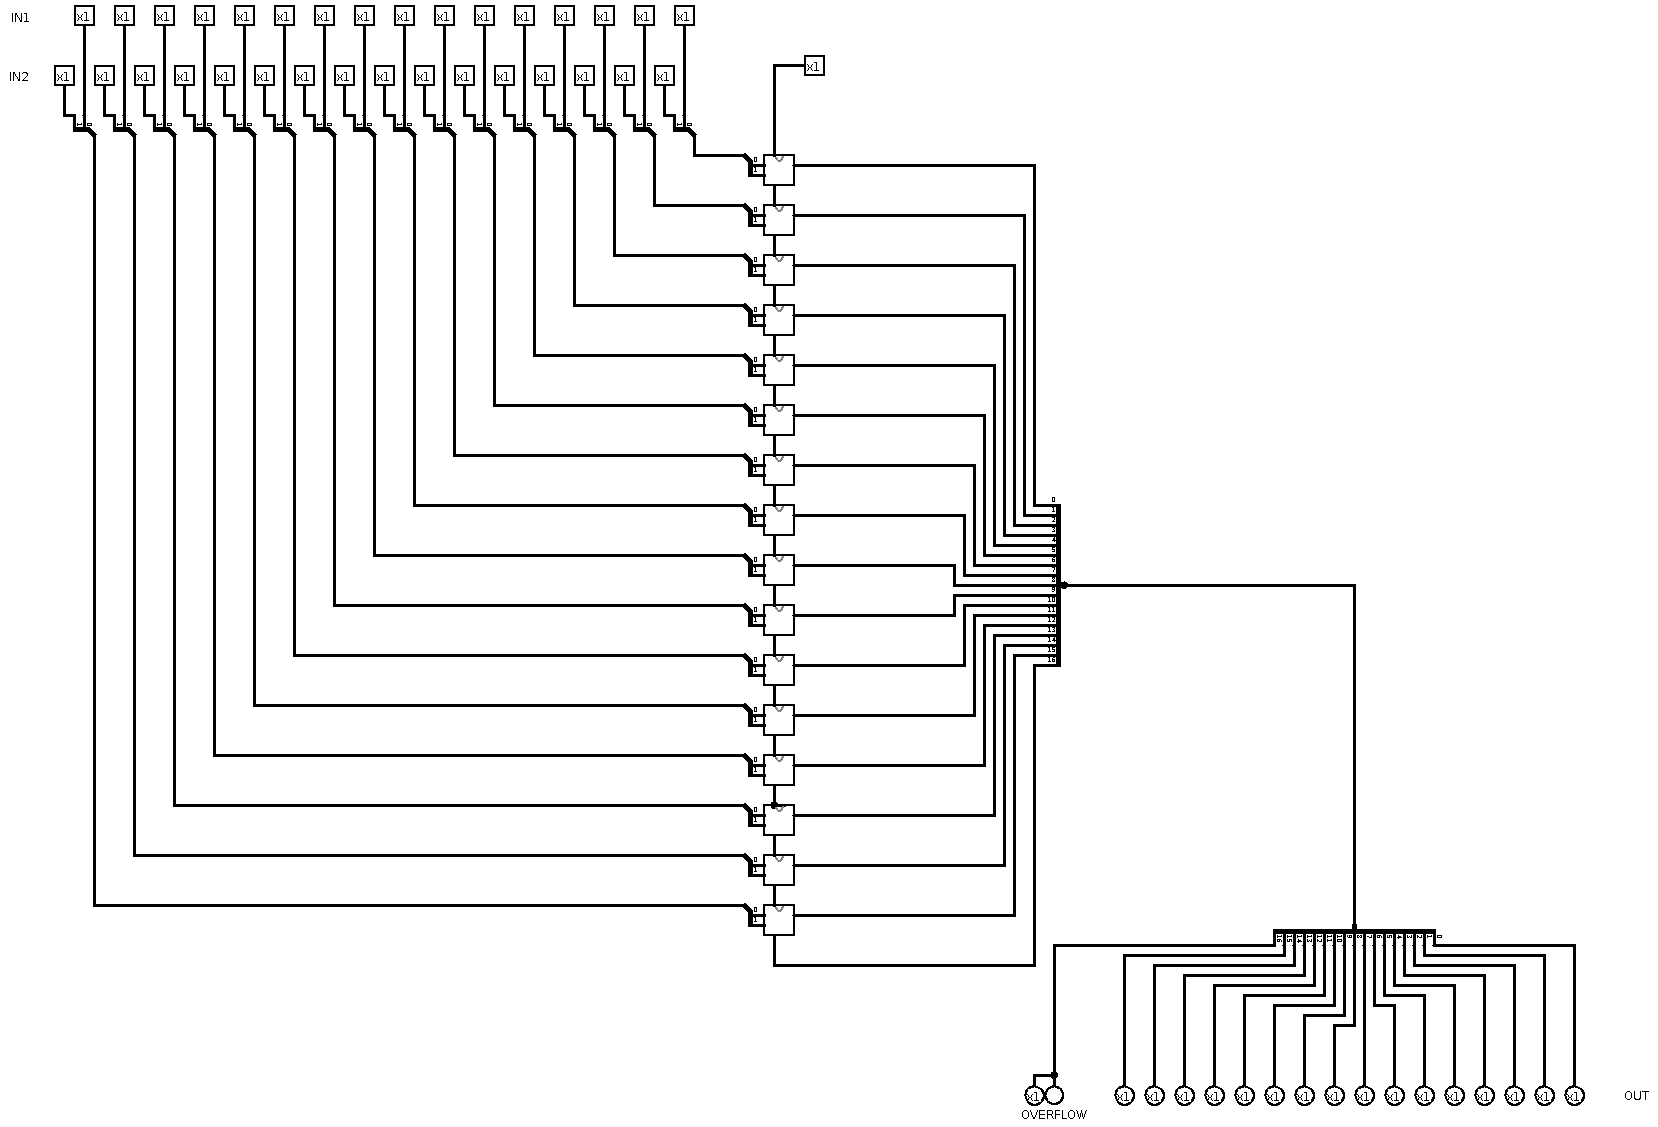
alleen zijn de bits hier van klein naar groot gerangschikt, terwijl het normaler is om ze van groot naar klein te sorteren. Dit is een voorbeeld van een goed gerangschikt model:
c) Bij voorgaande schema's kan je een "overflow" bit vinden, dat simpelweg het signaal van de overflow van de laatste schakeling (optelling) gebruikt. Als het signaal daar aan staat, is dat het equivalent van een kind een optelling van 65 + 94 te laten doen, terwijl het kind maar tot 100 kan tellen. Net zoals het kind is onze 16-bit adder niet klaar voor een optelling die overflow genereert.
Tot nu toe hebben we een unsigned adder gemaakt, wat niet gevraagd werd: gevraagd was een 2's complement adder, waarbij de eerste bit aanduidt of het getal negatief is of niet. Dit verandert niet veel aan de adder zelf, omdat het principe van 2's complement zo gemaakt is dat de adder werkt, behalve bij optellingen met een uitkomst boven 2^15-1 of onder -2^15. Ons compacte model wordt nu:
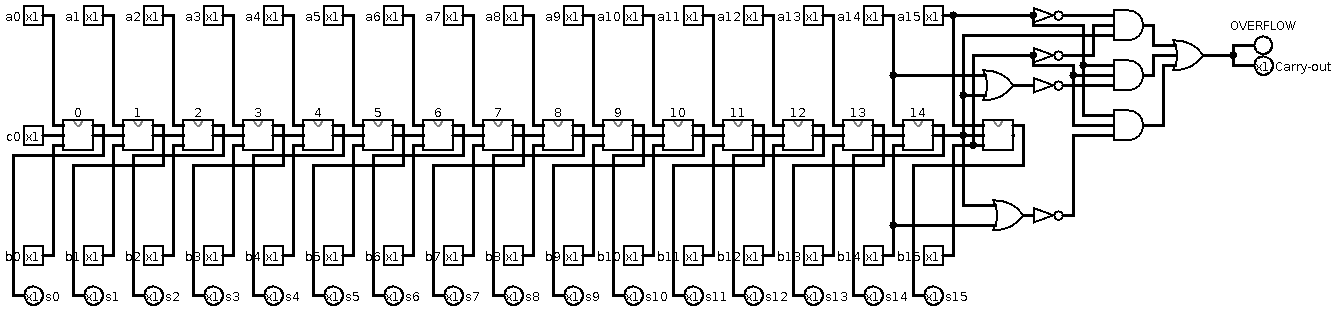
en het gerangschikte model analoog hieraan. We hebben nu overflow, zoals gezegd, in gevallen waar de uitkomst boven 2^15-1 of onder -2^15 zou komen.
Oefening 3: Opbouw van een 4-bit adder en een 16-bit carry lookahead adder
a) We maakten een nieuwe schakeling aan voor een 4-bit adder, waarvan een deel gelijkaardig was aan de 16-bit ripple carry adder, daar we hier de carry-outs gebruiken van de berekeningen:
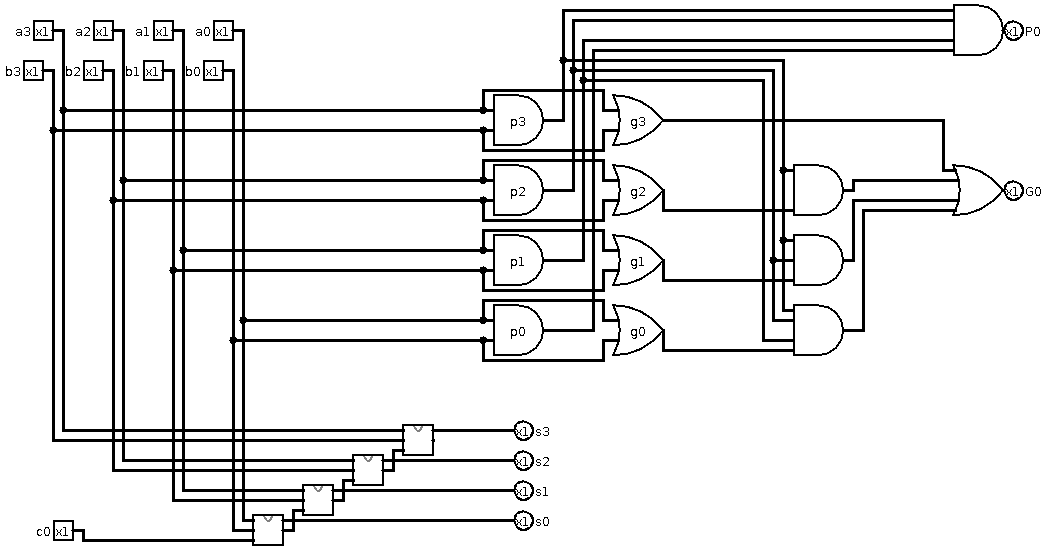
De rest van de implementatie volgt direct uit de theorie. Momenteel is ons langste pad (2*4)ε = 8ε (s3)
b) Voor de optimalisatie van onze 4-bit adder hebben we gekozen om een interne carry lookahead te doen met behulp van de propagate en generate bits. Hieronder tonen we het schema van deze carry counter:
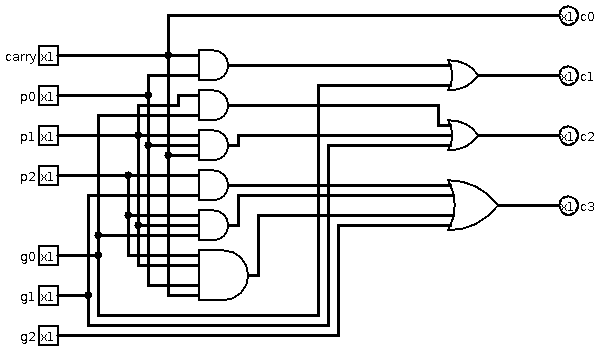
Men kan opmerken dat we geen carry-out voor de 4e optelling (c4) implementeren, dit is omdat we een 4-bit adder maken, die al een superpropagate en een supergenerate bit bevat. Dit maakt deze carry-out onnodig. Het langste pad van deze carry counter is 2ε.
Als we deze carry counter nu ook in onze 4-bit adder implementeren, geeft dat een langste pad van 5ε, wel wat beter dan ons eerste model. Zie onderstaand schema:
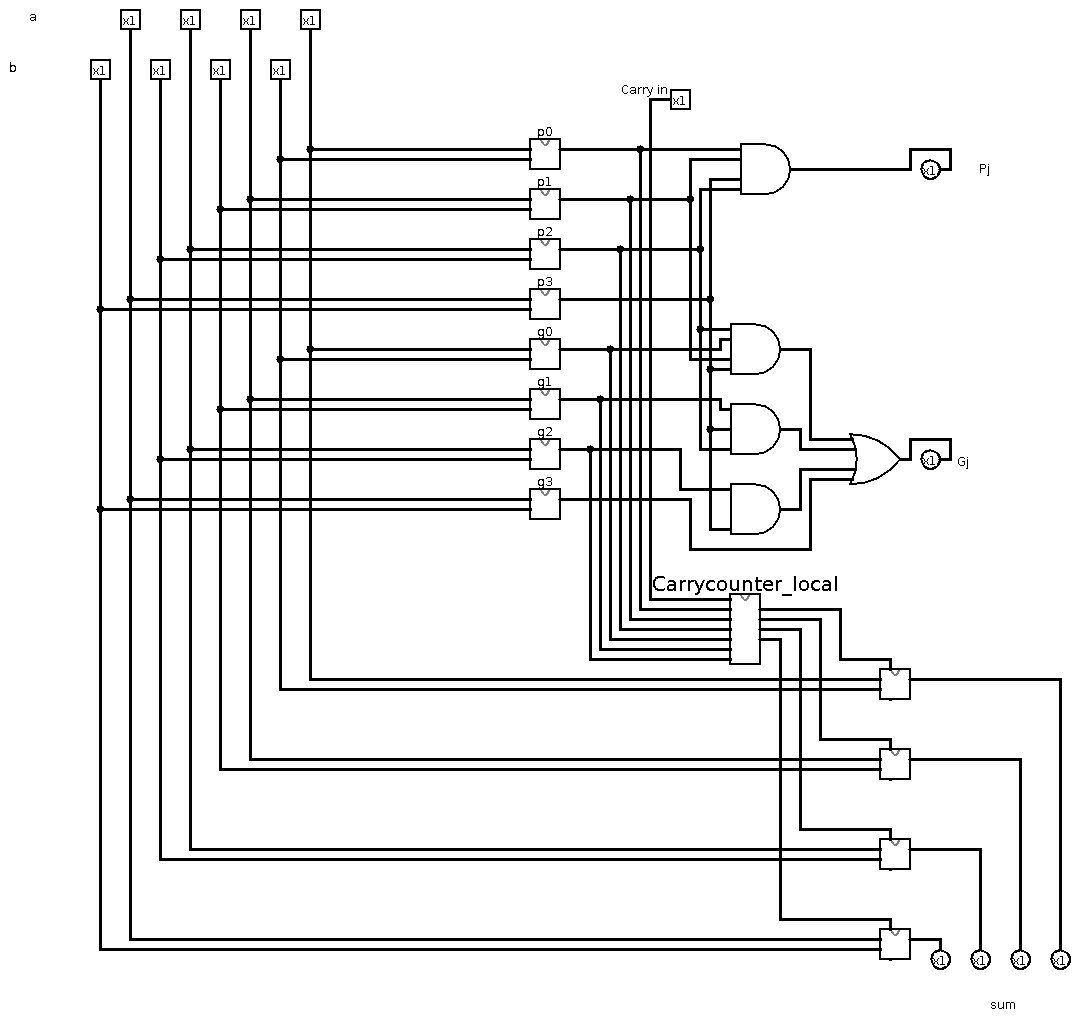
Als we wilden, konden we ook een circuit maken voor een 4-bit adder met 2ε, maar die zou dan 2^9 = 512 AND-gates gebruiken, wat natuurlijk een beetje buitenproportieel is, en heel kostelijk zou zijn. In ons huidige circuit hebben we namelijk maar 70 poorten nodig!
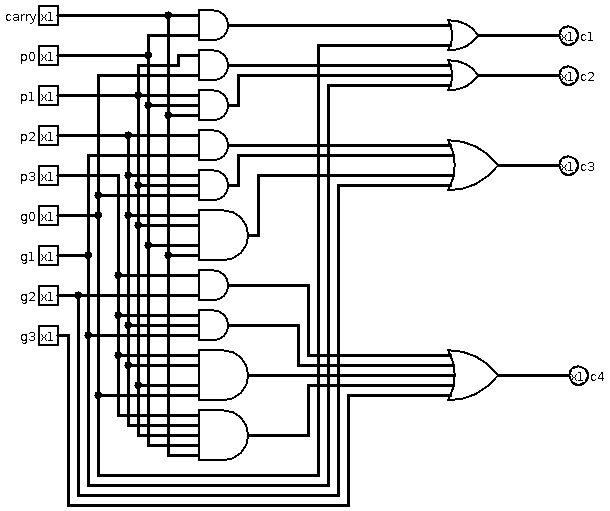
c) Nu hebben we wel een CLU gemaakt die heel analoog is aan de carry counter die we in (b) geimplementeerd hebben, maar hier wordt c4 heel belangrijk, dus voegen we die wel toe:
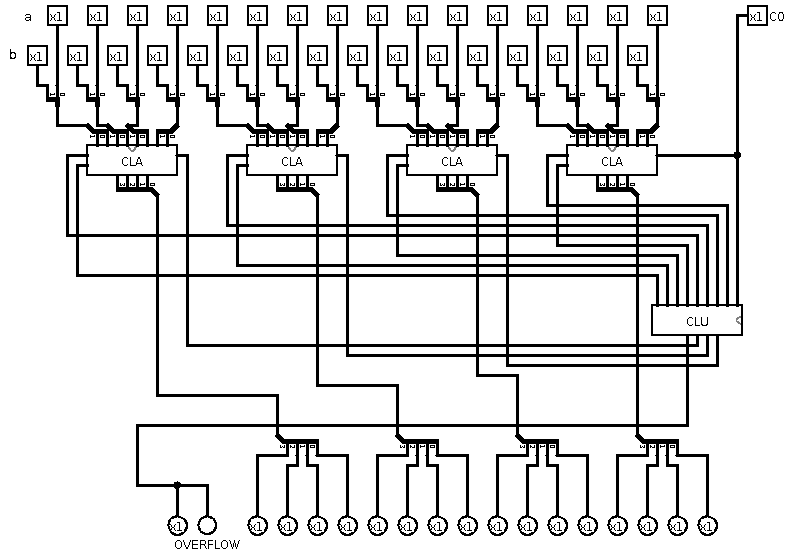
En tot slot voegen we de efficientere 4-bit adders samen met deze CLU, om onze 16-bit carry lookahead adder af te werken:
d) Nu hebben we een overflow-bit voor een unsigned adder. We moesten weer een 2's complement adder maken, wat gelukkig alleen een verandering in de overflow benoodzaakt.
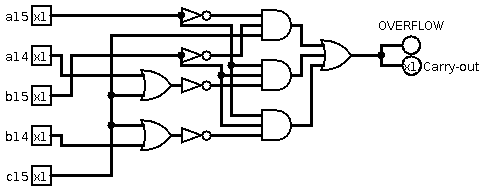
De huidige overflow heeft dus geen betekenis in een 2's complement adder. We implementeren dus, analoog aan onze 2's complement ripple carry adder, een overflow-circuit via bits a15, b15, a14, b14 en de carry-out c15. Deze implementatie volgt namelijk uit het volgende schema:
| a15 |
a14 |
b15 |
b14 |
c15 |
< -32 768 |
> 32 767 |
| 0 |
x |
0 |
x |
1 |
0 |
1 |
| 0 |
x |
0 |
x |
0 |
0 |
0 |
| 1 |
x |
0 |
x |
x |
0 |
0 |
| 0 |
x |
1 |
x |
x |
0 |
0 |
| 1 |
0 |
1 |
x |
0 |
1 |
0 |
| 1 |
x |
1 |
0 |
0 |
1 |
0 |
| 1 |
1 |
1 |
1 |
x |
0 |
0 |
| 1 |
1 |
1 |
x |
1 |
0 |
0 |
| 1 |
x |
1 |
1 |
1 |
0 |
0 |
Dus: overflow = a15·b15·c15 + a15·b15·c15·a15 + a15·b15·c15·b15
wat equivalent is met: a15·b15·c15 + a15·b15·(c15 + a15) + a15·b15·(c15 + b15), wat in onze adder wordt geimplementeerd.
Oefening 4: Controle van de 16-bit adders
a) Deze oefening was redelijk triviaal. Om de outputs effectief te vergelijken hebben we XNOR-poorten gebruikt, want die geven 0 terug als en slechts als er exact 1 output binnenkomt.
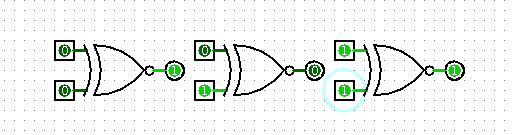
Dit is handig omdat we voor elke outputbit willen controleren of de adders dezelfde output geven. Als ze dezelfde output geven voor een gegeven bit, wilt het zeggen dat er ofwel 0 ofwel 2 signalen toekomen op de XNOR. Als 1 XNOR geen signaal doorlaat hebben we dus een probleem, dit geheel implementeren we als volgt:
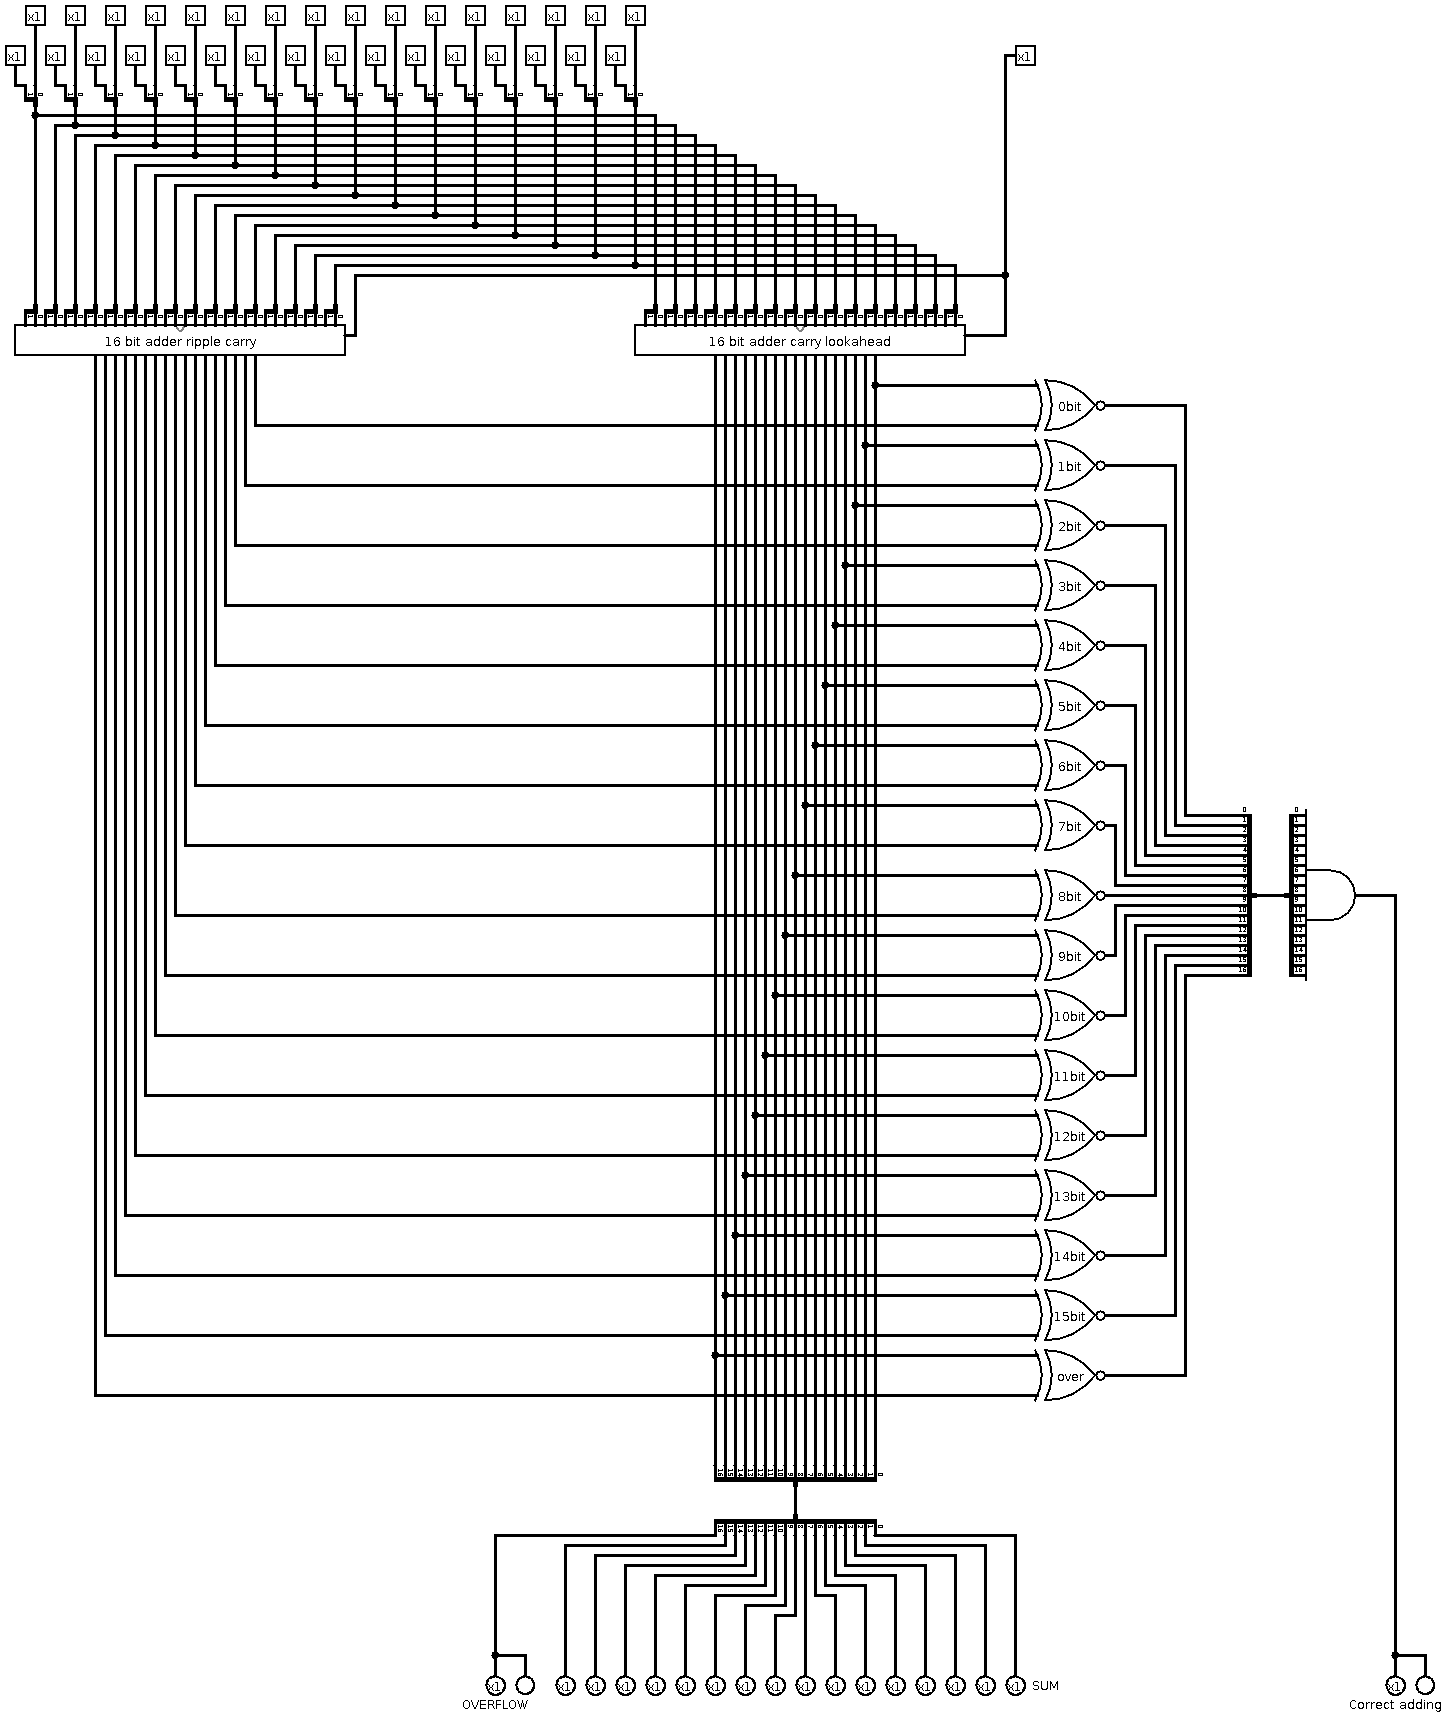
b) 16-bit ripple carry adder: We hadden hier latency 2ε per 1-bit adder, dus (2*15)ε = 30ε.
Voor de overflow te berekenen moeten we daar nog 3ε bijtellen, wat ons 33ε levert.
16-bit carry lookahead adder: Het langste pad is duidelijk voor de overflow, dat de voorlaatste carry-out van de laatste 4-bit adder gebruikt. De berekening begint: latency om de superpropagate en supergenerate te berekenen is 3ε. Dan volgt een latency van 2ε bij de carry counter, en na nog eens 2ε wordt de carry-out berekend die nodig is voor de overflow. De vraag of er overflow is, wordt dan na nog eens maximaal 3ε berekend, wat een totale latency van 3 + 2 + 2 + 3 = 10ε oplevert, wat de carry lookahead adder meer dan 3 keer zo snel als de ripple carry adder maakt.
Project 3: ALU
Stap 1: Opsplitsing van ALU in aparte bewerkingen
We hebben 16 bewerkingen/operaties die we moeten implementeren in onze ALU. Uit die 16 operaties hebben we telkens slechts 1 nodig afhankelijk van de nodige operatie. Wat we ook snel kunnen opmerken is dat we operaties in twee verschillende types kunnen onderscheiden. Voor type 1 hebben we operaties die de 1 signaal of 2 signalen per bit bewerken. In type 2 zien we dan logischer wijze de operaties die op volledige 1 of 2 16-bit signa(a)l(en) een operatie uitvoeren. Hieronder een tabel met de onderverdeling per type. (zie later ook in stap 3)
| Type I |
Type II |
| generate 0 |
addition (+) |
| NOT |
subtraction (-) |
| AND |
numeric inverse |
| OR |
shift left logic |
| less than (<) |
shift right logic |
| greater than (>) |
shift left arithmetic |
| equal (=) |
shift right arithmetic |
| not equal (=/=) |
|
| no operation |
|
We kunnen nu voor type I 1-bit elementen maken, wat we hieronder ook gaan doen voor elke operatie.
+ Type I
* 0 generator
Hier zoeken we een statement die bij het binnenkomen van 1 signaal (uit a), altijd een 0 zou genereren. Stellen we even een waarheidstabel samen, dan krijgen we het volgende:
Wat we ons uit lessen logica kunnen herinneren, is het feit dat A·A = 0 (de inverseregel). Dit kunnen we ook noteren als A AND (NOT A) en dit is makkelijk te implementeren met volgend schema:
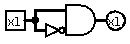
* AND, OR, NOT
Hier maken we gebruik van de basiscomponenten, de aansluiting hiervan zal later duidelijk worden in een overzichtelijk schema.
* "greater than" en "less than"
Om aan de implementatie van vergelijkingselementen te beginnen, hebben we kleine waarheidstabellen opgesteld voor beide bewerkingen. In beide gevallen hebben we genoeg aan een AND-element, wat in het schema als volgt wordt voorgesteld:
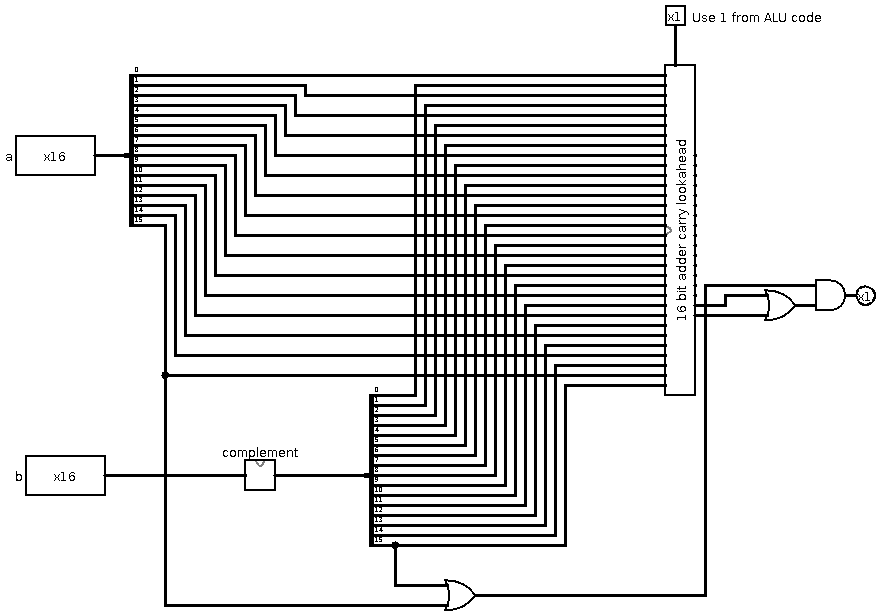
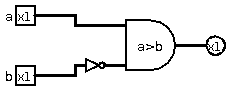
* === vs. =/=
Als we terug beginnen met het opstellen van waarheidstabellen merken we gelijkenissen met de waarheidstabellen van XNOR en XOR elementen. Om echter wat plaats en elementen te besparen, gebruiken we het outputsignaal van 1 element en gaan we parallel een NOT aansluiten.
* no operation
Het doorgeven van het signaal is de meest triviale operatie, die geen elementen nodig heeft.
+ Type II
* addition
Voor optelling gaan we gebruik maken van onze (unsigned) lookahead adder uit vorige oefening (om te beginnen). De gevolgen zullen we zien bij de testen.
* subtraction
Om een verschil te kunnen berekenen gaan we gebruik maken van onze adder en de eigenschap van 2's complement. We beginnen met een korte afleiding:
x + x = -1
-x = x + 1
a - b = a + (-b) = a + (b + 1) = (a + b) + 1
b kunnen we krijgen door het complement te nemen: alle bits NOT-en. We kunnen dan dezelfde adder gebruiken als bij addition. Nu blijft enkel + 1 staan zonder gebruikt te worden. Zoals we uit vorig projectje weten, heeft onze adder een Carry In die altijd 0 is bij optelling. De bewerking die de adder eigenlijk doet is a + b + 0 , waarbij de + 0 de Carry In is. Hieruit kunnen we besluiten dat als we Carry In 1 maken, dan implementeren we hiermee + 1 die we nodig hadden. Dit is enkel mogelijk omdat Carry In een 1-bit getal is en ook overeenkomt met de least significant bit (LSB).
Om 1 gemeenschappelijke adder te gebruiken, moeten we een inputsignaal voor Carry in goed kiezen. Kijken we naar de ALU-codes voor som (0100) en verschil (0101), dan merken we dat de LSB hier de juiste Carry In-waarde heeft voor elke bewerking. Die gaan we dus aansluiten aan de Carry In.
* numeric inverse
Om een numerieke inverse te berekenen gaan we terug even kijken naar uitdrukking -x = x + 1 . We leiden uit deze formule af, dat we een complement moeten nemen en daarbij een 1 optellen. Dit principe zal liggen aan de basis van onze implementatie van -x (de numerieke inverse)
* shift left logic (sll) en shift right logic (srl)
Twee bijna vanzelfsprekende operaties die gebaseerd zijn op verschuiving van signaallijnen in de naastliggende input. Enige plaatsen waar we problemen kunnen ondervinden zijn randbits. Omdat we geen overflow hebben, gaan we de laatst verschuivende bit nergens doorgeven (sll). Op de plaats van de eerst verschoven bit, kunnen we geen leegte laten, dus gaan we een 0 plaatsen op de lege plaats (srl).
* shift left arithmetic (sla) en shift right arithmetic (sra)
Gelijkaardig aan voorgaande bewerkingen, hebben we ook een koppel arithmetische bewerkingen, die vergeleken kunnen worden met vermenigvuldiging en deling door 2. Er zijn echter verschillen met voorgaande bewerkingen door de eigenaardigheden van 2's complement. Zo hebben we een sign-bit die het teken van ons getal bepaalt. Daarom wordt het 16de bit niet zomaar doorgegeven. We moeten die bijhouden en in geval van sra geven we die dan ook niet door naar de 15de bit. In geval van sla wordt de 16de bit niet aangetast en passen we het principe van sll toe op de eerste 15 bits, met overflow waar nodig.
Bij onze eerste testen hebben we gemerkt dat onze implementatie een aantal grote problemen ter grote van de Mount Everest kleine onnauwkeurigheden hadden waardoor onze output door de testprogramma fout werd geinterpreteerd. Dat is ook de reden waarom we geen afbeeldingen hebben geplaatst. Onze grootste problemen waren volgende:
- adder die enkel met unsigned numbers werkte
- geen correcte true/false waarden bij vergelijkingen
- fouten bij aansluiting van sll, sla, srl, sra
- logisim die regelmatig rare resultaten weergaf bij het testprogramma (wat niet aan onze kant ligt)
Een zeer kort lijstje dat veel problemen kan opleveren. Daarom werd er de meest pijnlijke beslissing genomen, bijna volledige heropbouw van het ALU-schema.
Stap 3: Heropbouw van de ALU
Omdat uit onze vorige ervaring bleek dat meeste van onze operaties meer bewerkingen nodig hebben nadat ze per bit werden bewerkt, besloten we om daaraan aparte bewerkingsblokken te geven of zelfs op een ander manier te berekenen. Hierdoor krijgen we volgend schema.
| Type I |
Type II |
| generate 0 |
addition (+) |
| NOT |
subtraction (-) |
| AND |
numeric inverse |
| OR |
shift left logic |
| no operation |
shift right logic |
|
shift left arithmetic |
|
shift right arithmetic |
|
less than (<) |
|
greater than (>) |
|
equal (=) |
|
not equal (=/=) |
Omdat in onze type I niets is bijgekomen, kunnen we onze vorige implementatie de 1-bit ALU met enkele ingebouwde bewerkingen overnemen. Door alle overbodige 1-bit operaties weg te gooien en op plaats ervan inputsignalen voor zelfde bewerkingen te maken, krijgen we:
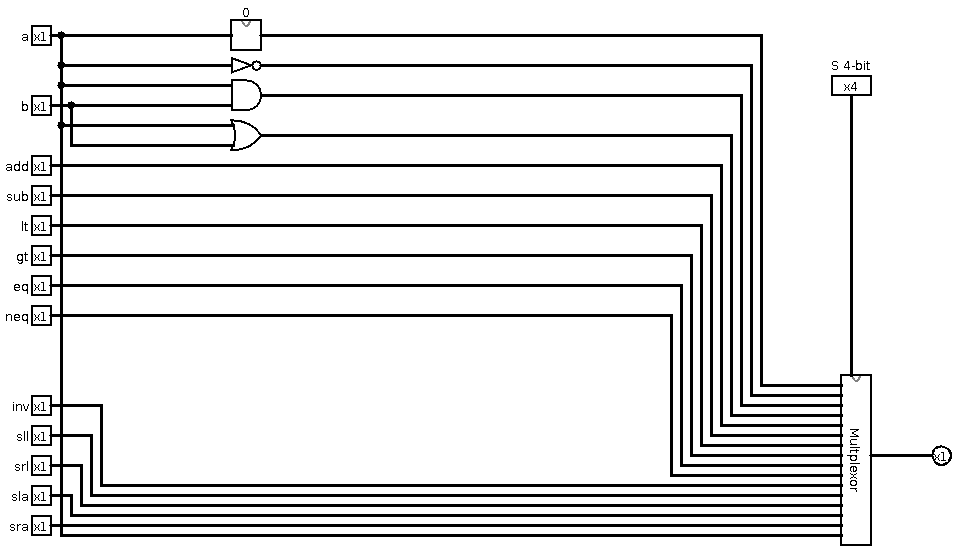
In dit schema zien we een multiplexor verschijnen. Deze geeft voor elke bewerking een signaal door zoals volgt:
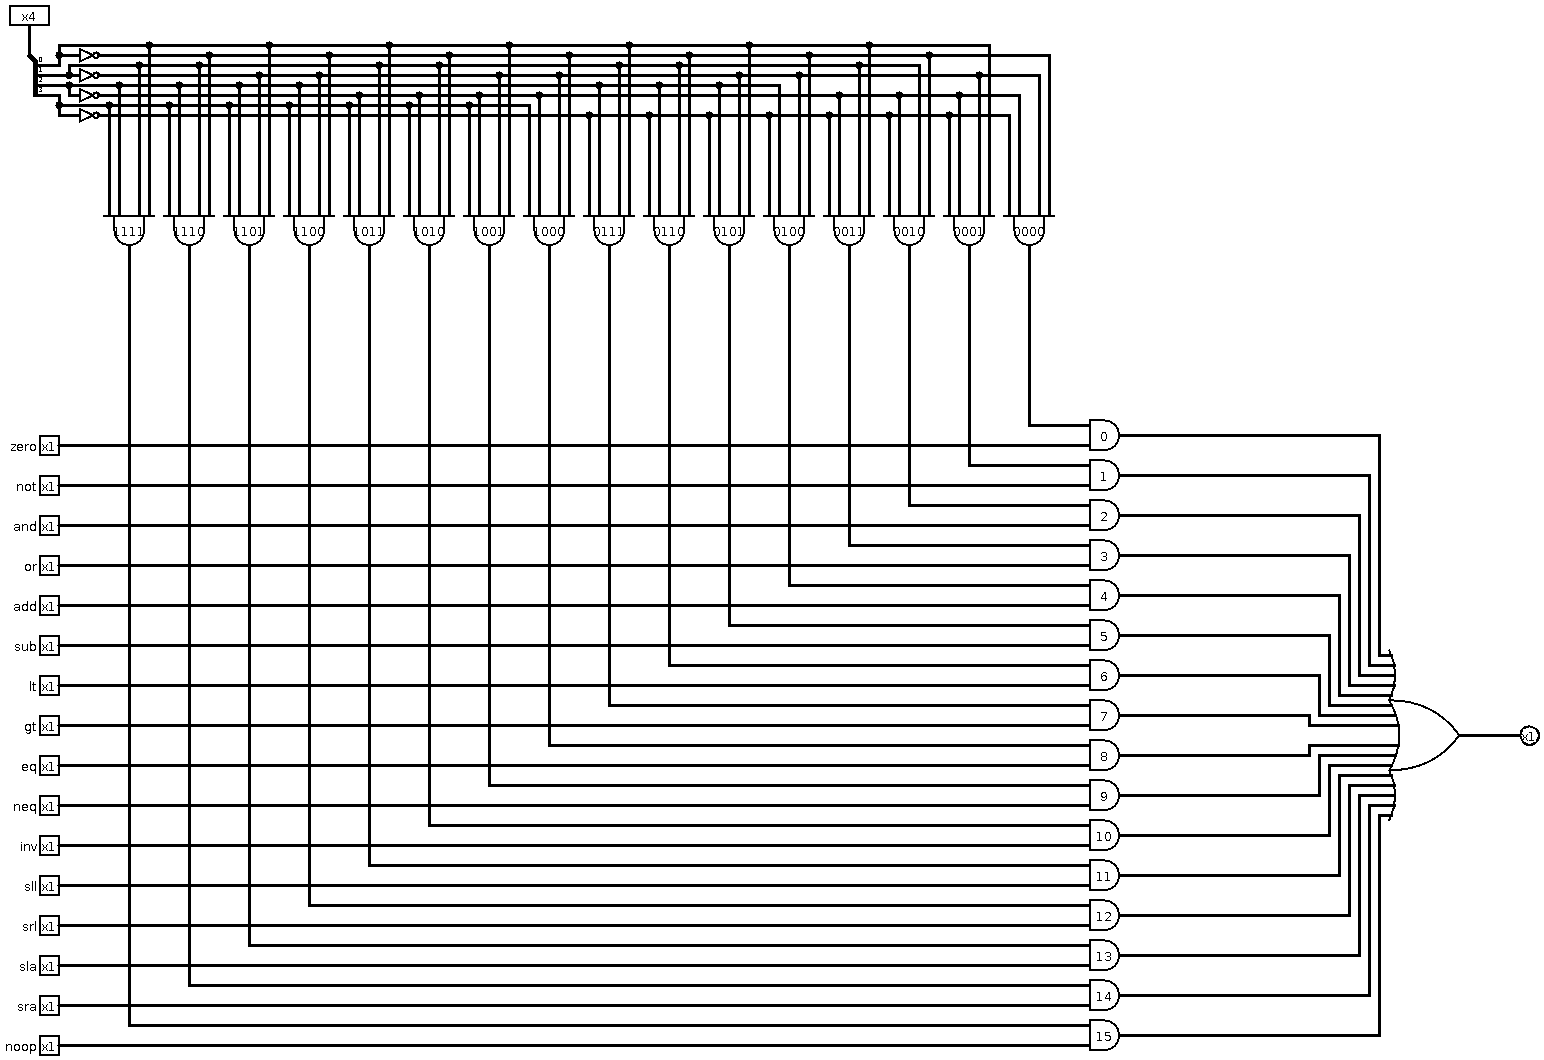
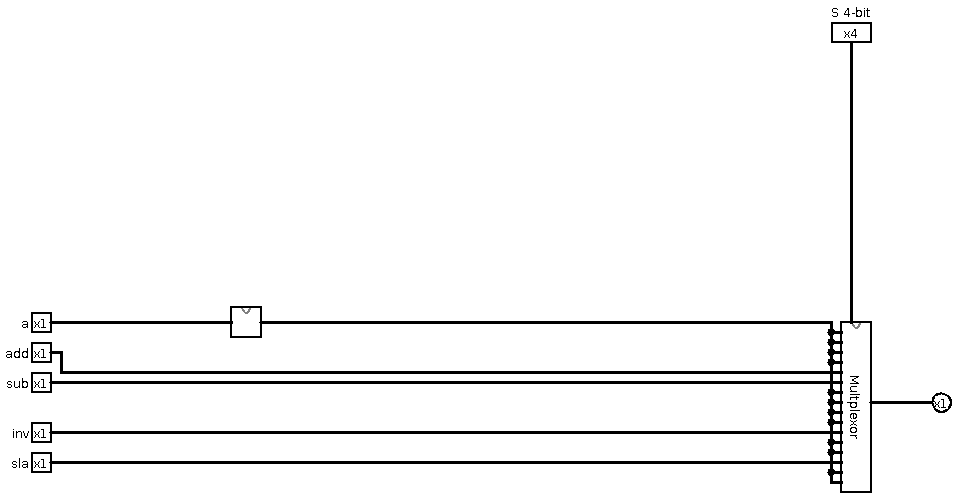
Nu moeten we eraan denken dat we bij sommige operaties een overflow hebben. Om het makkelijk te maken gaan we een aantal dingen uit die ALU weggooien en het signaal van onze zero generator gebruiken om een 0 te genereren waar geen overflow mogelijk is. Hierdoor zal onze 17de 1-bit ALU er als volgt uitzien:
Voor we naar onze volledige 16-bit ALU gaan kijken, bekijken we eerst de meest belangrijke onderdelen die allemaal voor een 1-bit ALU gebeuren. Zoals eerder vermeld gebruiken al deze operaties een 16-bit getal en geven ze per bit een output.
+ Addition +
Door een beetje aan onze adder te prutsen, hebben we er een gekregen die wel met 2's complement kan werken. Zijn schema zit er als volgt uit:
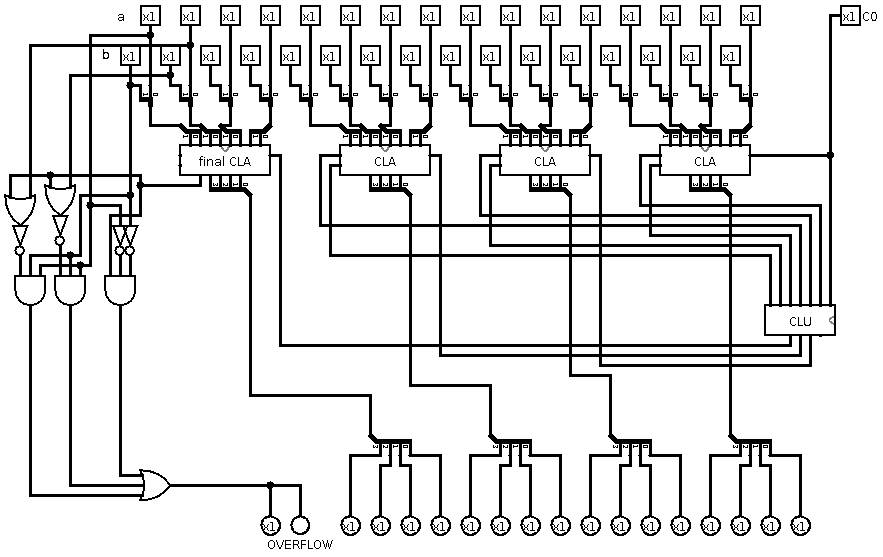
Hier zijn de problemen met het teken dan ook weggewerkt.
+ Subtraction +
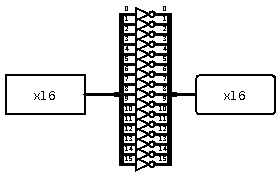
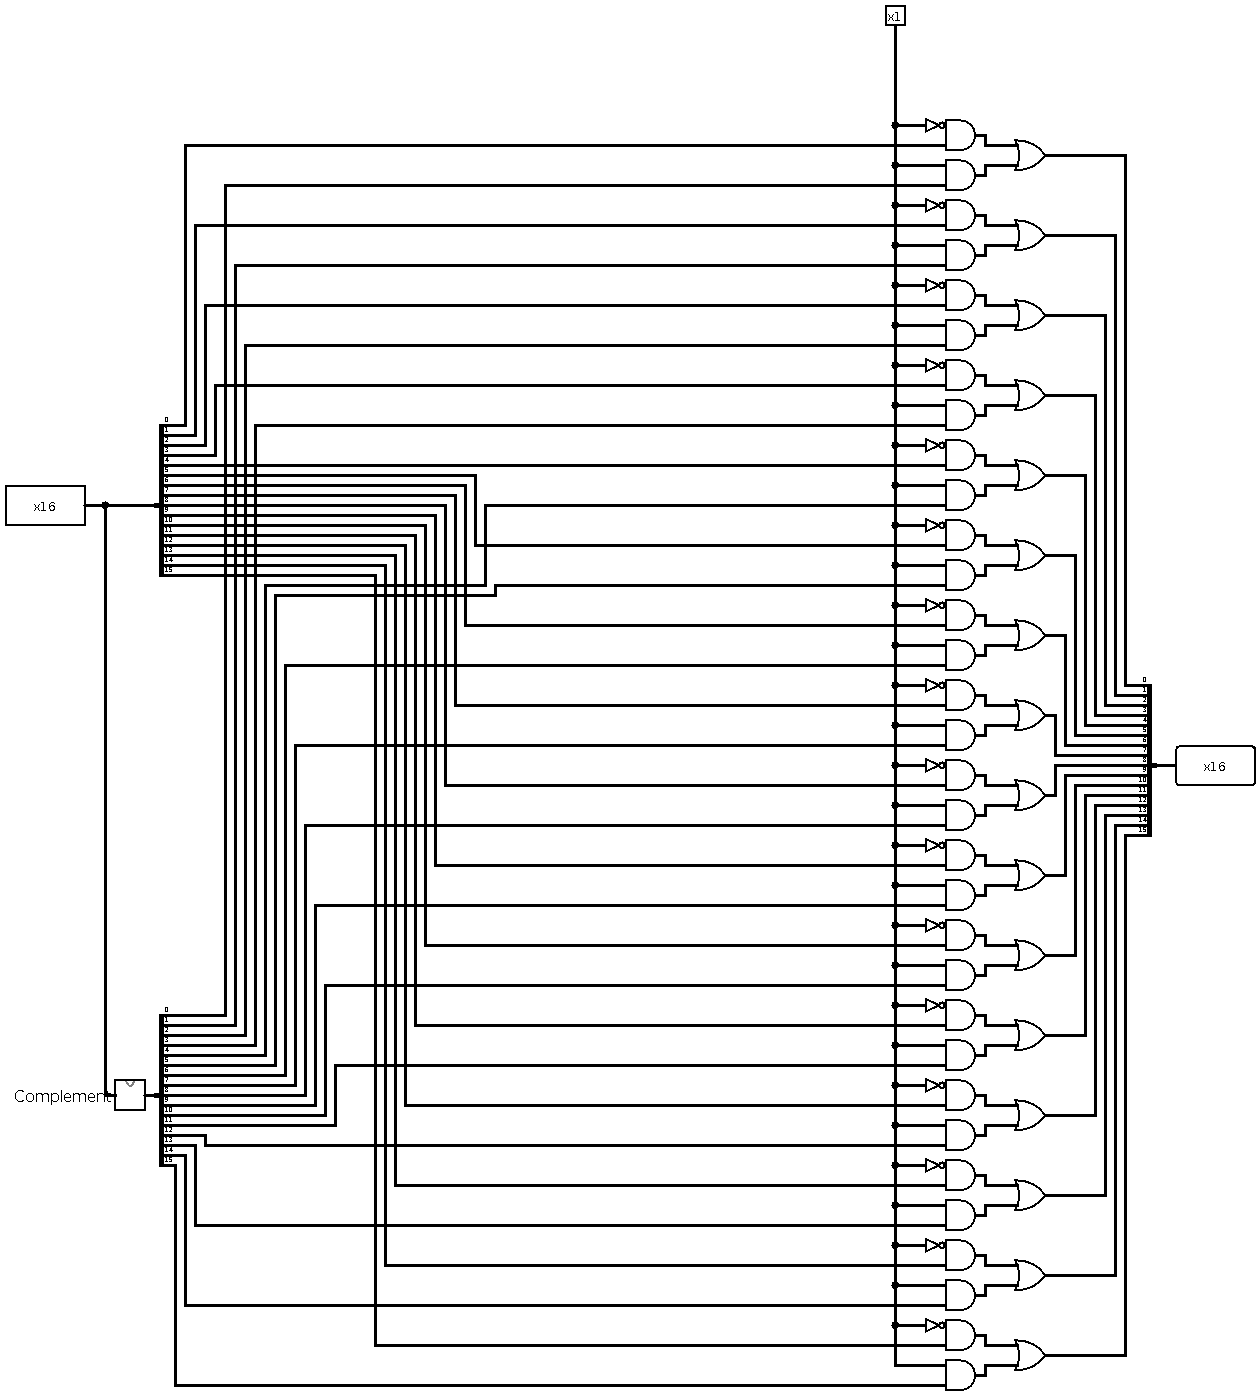
Doordat onze adder nu correct werkt, kunnen we de verschilmethode van hierboven gebruiken. Het complement van getal b wordt enkel in subtraction berekend, via een apart element (ook al kon die ook best gebruikt worden voor vergelijkingselemnten om plaats te besparen). het element voor het complement ziet er als volgt uit:
Die is dan verwerkt in volgende multiplexor:
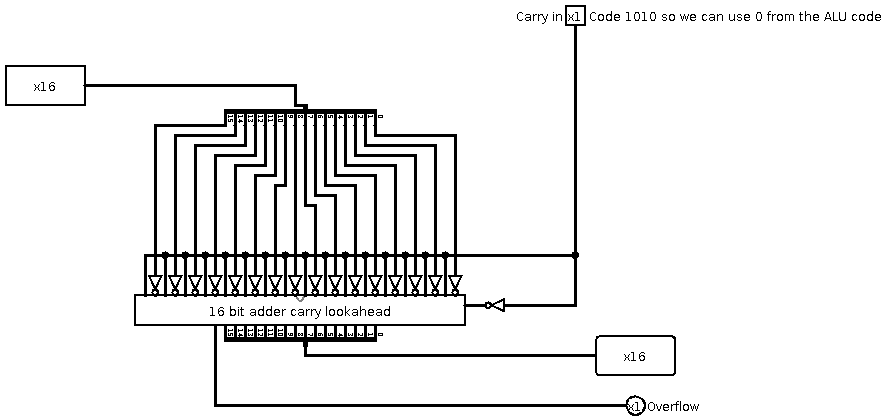
+ numeric inverse +
Het principe blijft hetzelfde als hierboven beschreven. Het schema is ook heel simpel en duidelijk:
+ lt, gt en eq, neq +
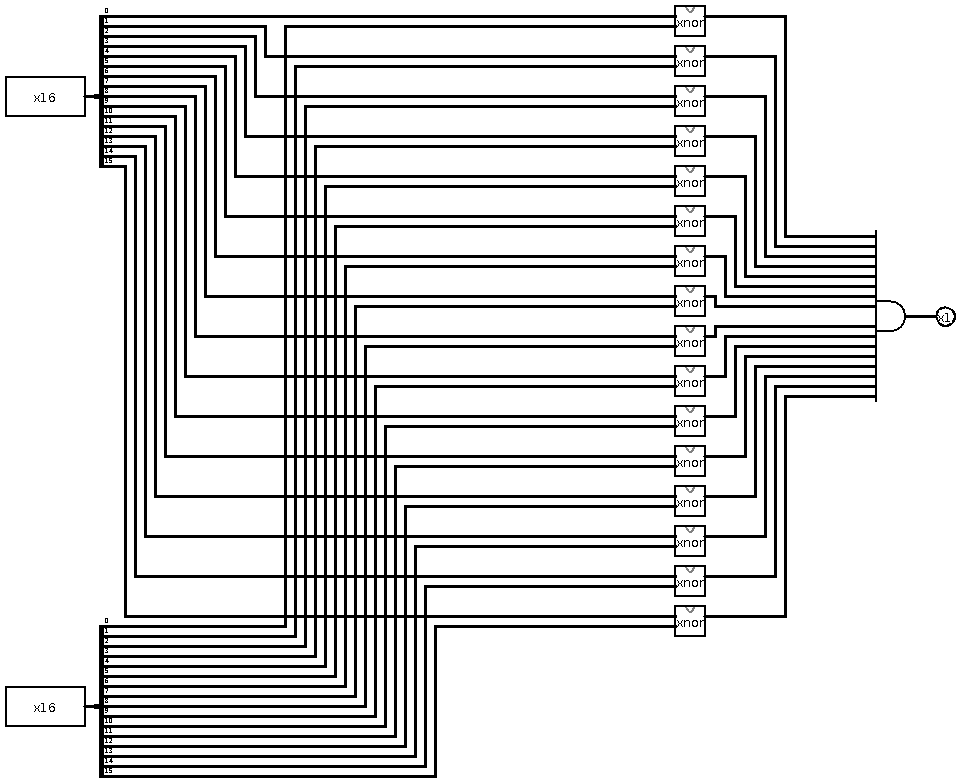
Hier zijn we eindelijk angekomen aan de vergelijkingselementen. We beginnen met de makkelijkste vergelijking genaamd gelijkheid. We gaan zoals ervoor ook per bit de twee getallen vergelijken. Het meest passende logische element ervoor is de XNOR. Als alle bits gelijk zijn, dan krijgen we overal een 1. Dit zal dan voor ons een "true" betekenen, die de vorm 0000 0000 0000 0001 heeft. Dit betekent dat we hiervoor een AND-poort voor 16 inputs kunnen gebruiken om de uitgaande bit op plaats 0 te zetten. Het schema van dit element zal er dan als volgt uitzien:
De ongelijkheid is de ontkenning van een gelijkheid, wat gewoon met een NOT wordt doorgegeven.
Nu gaan we over naar het moeilijkste element. Onze uiteindelijke implementatie is gebaseerd op het verschil van 2 getallen en is afhankelijk van het teken van het verschil (en de eventueel gevormde overflow). Om het aantal elementen te verminderen gaan we enkel het circuit voor "<" implementeren. Door een kleine constructie in combinatie met het gelijkheidselement kunnen we daarmee ook zeggen of de vergelijking ">" ook geldt. Hier konden we trouwens het aantal elementen verminderen door de subtractor te gebruiken die we combineren met onze adder. Het less than (<) element krijgt dan deze vorm:
+ sll, sla, srl, sra +
Hier zijn we eindelijk aangekomen aan de laatste operaties. Ahh, ging het maar even snel met tekenen, als het verslag lezen. De sll en sla zijn geintegreerd in onze grote ALU. Daarom gaan we deze twee operaties niet bespreken. Voor sla en sra zijn er aparte elementen gemaakt die ook niet veel uitleg vragen omdat die hierboven al werd gegeven.
sra:
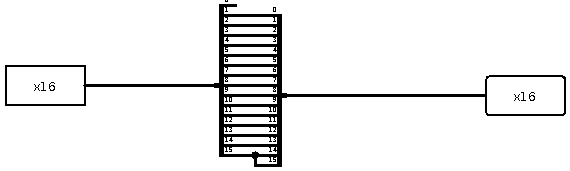
Misschien is enkel bij sla een kort uitleg nodig. We hadden het al hierboven vermeld dat dit overeenkomt met vermenigvuldiging door 2. Omdat we niet in staat zijn om te vermenigvuldigen moeten we iets anders doen. Uitwerken levert ons 2 * a = a + a. Omdat optellen wel een makkelijk te implementeren operatie is, gaan we die toepassen.
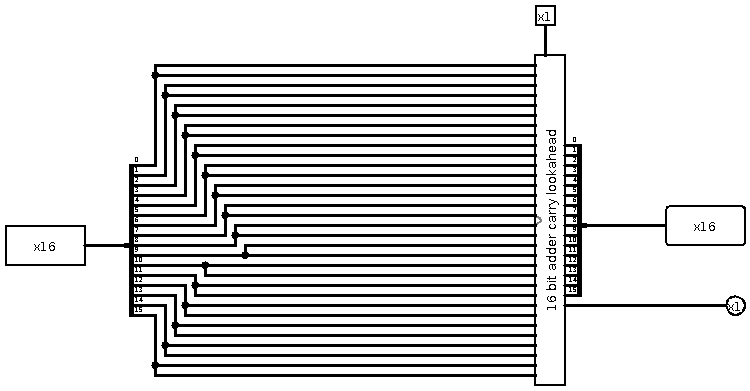
Nu kunnen we eindelijk eens een kijkje nemen op het hoofdschema genaamd de 16-bit ALU:
Hoofdschema in spoiler (klik hier om te zien)
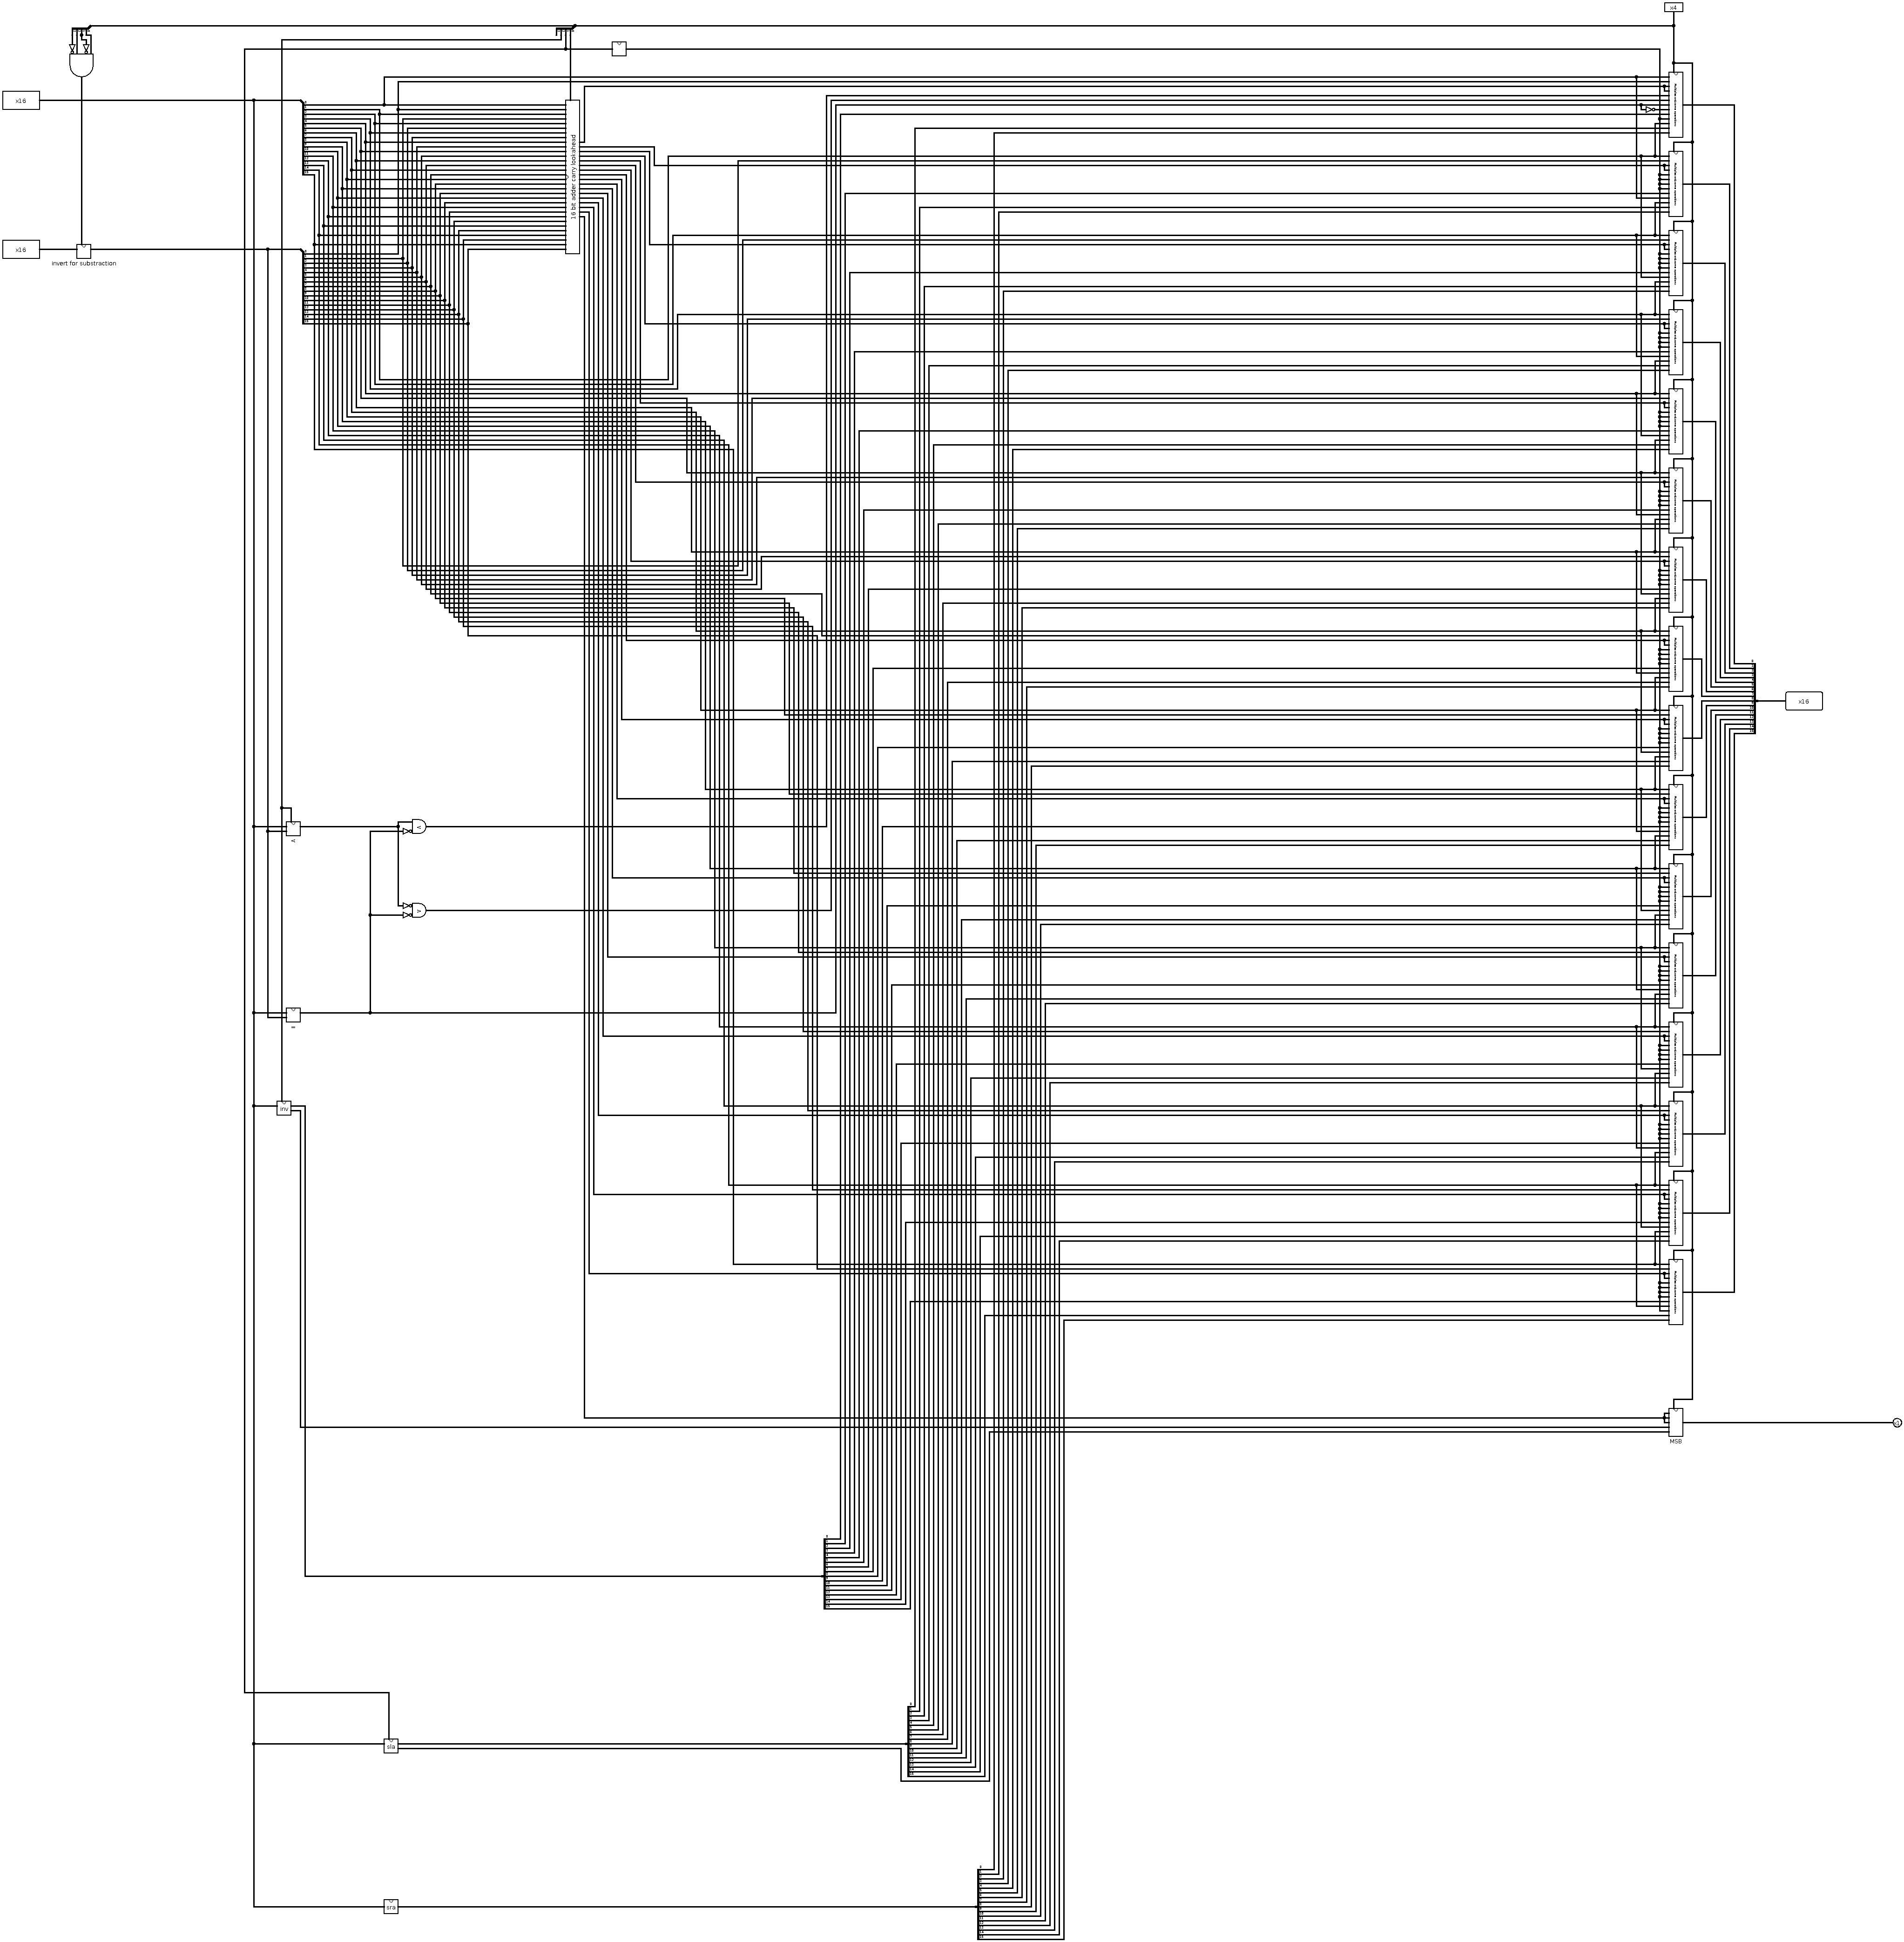
Deze lijkt misschien wel groot, maar die is gewoon wat verspreid voor meer overzichtelijkheid. Wat er nog niet werd vernoemd in ons verslag zijn de inputsignalen bij sommige elementen die bij bediening van elementen nodig zijn, die worden uit de bits van selectsignaal genomen afhankelijk van operatie. Van boven is er ook nog een zero generator gebruikt om de signalen die altijd 0 zijn te implementeren (bv. bij vergelijkingen zijn alle bits 0 behalve de 0de bit die de "true/false" weergeeft).
Deze ALU werd dan via een extra abstractielaag in het hoofdcircuit ingevoerd. Nu zijn we eindelijk aan een korte bespreking van de testen.
Stap 4: Bidden dat alles werkt Nog eens testen
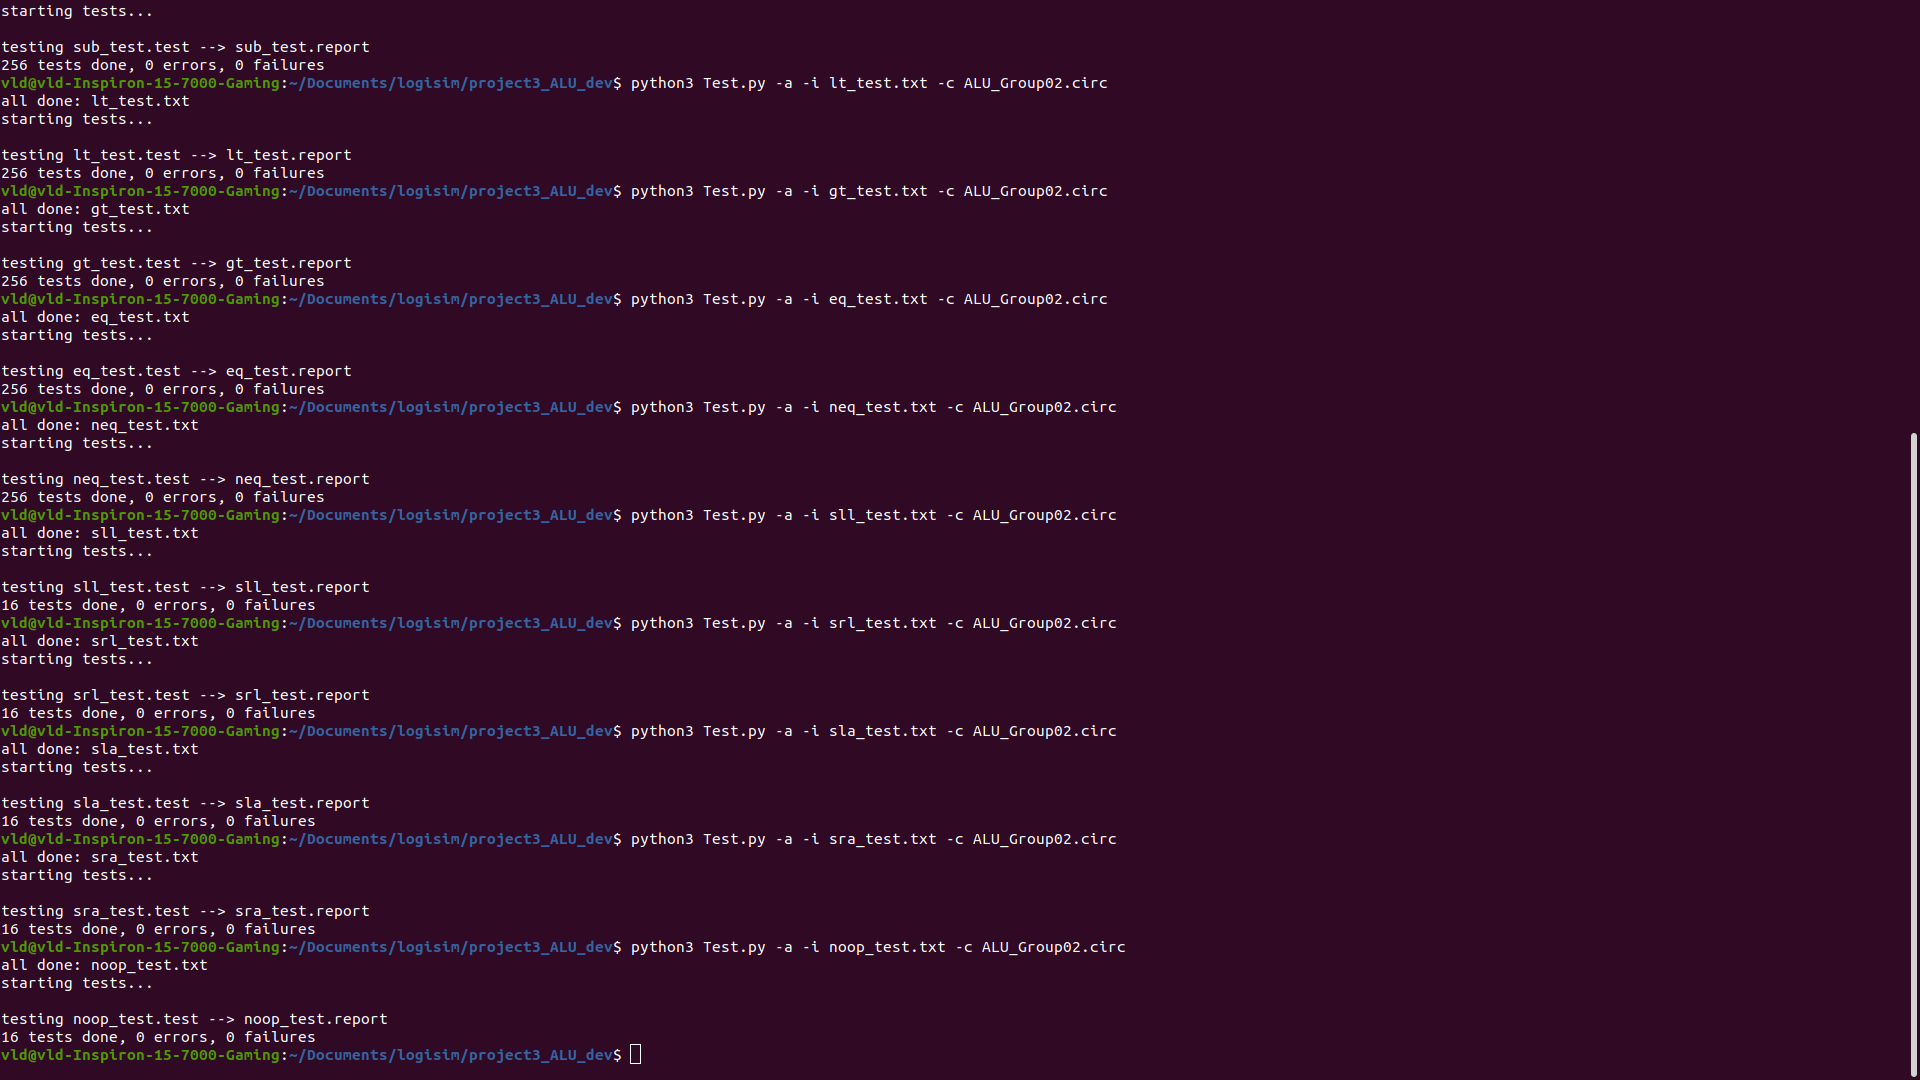
Nadat we onze ALU voor de tweede keer hadden opgebouwd, heeft bijna alles van de eerste keer gewerkt. Het enige probleem dat zich nog voordeed is dat het testprogramma soms een constante bit creeerde in ons resultaat. Bij de manuele controles kregen we dan wel de correcte waarden. Om dit probleem weg te werken, was het genoeg om logisim volledig af te sluiten en de terminal terug te herstarten. Uiteindelijk hebben we het langverwachte resultaat van hieronder gekregen. Onze blijdschap had geen grenzen. Een perfect werkend programma/schema kom je niet vaak tegen, dus dat kan gezien worden als overwinning.
Stap 5: Reflectie
Omdat het een onderzoek is, kunnen we niet eindigen met de woorden "It's working, goodbye!". Ja, ook al kan dit onderzoek niets nieuws in de wereld brengen, hebben we wel voor ons een nieuw vak ontdekt/langs binnen gezien en aangetoond dat deze veel makkelijker is dan het op eerste zicht lijkt.
Bij onze tweede implementatie hebben we gemerkt dat de types van operaties best anders werden opgedeeld. We merkten namelijk dat bijna alle operaties die we buiten de 1-bit ALU hebben gebracht, een adder gebruiken. Om het aantal elementen te verminderen, konden we proberen 1 adder te gebruiken, wat het aantal logische poorten zeker zou verminderen, maar waardoor de overzichtelijkheid hoogstwaarschijnlijk zou lijden. Het tweede type waren de 1-bit operaties die ook de signaalverschuivingen implementeerden. Die werden bij ons goed geimplementeerd en zouden in een compactere ALU bijna ongewijzigd overgenomen worden.
Om even kort samen te vatten, zou onze compactere ALU 1 adder moeten bevatten met iets ingewikkeldere aansluitingssysteem en de 17 1-bit ALU's. Deze implementatie zou misschien een aantal ε langer kunnen zijn dan die van ons, maar door het verminderde aantal elementen zou het waarschijnlijk de moeite waard zijn.
Nu we toch over latency begonnen zijn. kunnen we best eens kijken, hoe het daarmee zit bij onze ALU. Daarvoor gaan we kijken naar de langste operatie. We hebben zeker al 2ε bij de multiplexor op de output (Normaal is dat 3ε , maar dat geval is al zeker niet de langste weg hier. De 2ε zit er sowieso bij elke operatie.). De 1-bit operaties vallen ook allemaal weg uit onze varianten omdat ze maar 1ε toevoegen na de vorming van a en b signalen. Hierdoor zijn volgende operaties al weg uit onze berekening van latency: zero, and, or, not, noop, sll, srl, sra.
Kijken we nu naar de stabiliteit van signaal b, dan krijgen we 3ε. Hierbij hebben we een stabiel signaal a en b. Nu kijken we naar de langst mogelijke bewerking. Hierbij vallen de (on)gelijkheden weg omdat hun latency slechts 2ε bedraagt wat al zeker kleiner is dan die van de adder. Onze wegvallende operaties zijn dan eq en neq. Kijken we naar add, sub, inv en sla , dan merken we dat ze slechts 1 adder gebruiken wat in onze implementatie 10ε is. Kijken we naar lt (die ook gt implementeert). Dan zien we daar een adder die gevolgd wordt door 2 logische gates in serie, wat ons in totaal 12ε geeft. Maar onze signaal is nog niet stabiel, want in ons schema wordt lt gevolg door een AND-poort zowel voor lt, als gt. Dat zal ons dan een extra ε opleveren. In totaal krijgen we voor lt en gt 13ε om enkel dit element te doorlopen. Tellen we nu alles hiervan op dan krijgen we 3ε + 13ε + 2ε = 18ε . Maar dit geldt enkel door de implementatie van de carry-lookahead adder. Om dat wat overzichtelijker te maken, noteren we de latencies allemaal in een tabel.
| Operation |
Common formula |
Our implementation |
| Zero |
a + 1ε + 2ε |
3ε |
| NOT |
max(a,b) + 1ε + 2ε |
6ε |
| AND |
max(a,b) + 1ε + 2ε |
6ε |
| OR |
max(a,b) + 1ε + 2ε |
6ε |
| addition |
max(a,b) + adder + 2ε |
15ε |
| subtraction |
max(a,b) + adder + 2ε |
15ε |
| less than |
max(a,b) + adder + 2ε + 1ε + 2ε |
18ε |
| greater than |
max(a,b) + adder + 2ε + 1ε + 2ε |
18ε |
| equals |
max(a,b) + 1ε + 2ε |
6ε |
| not equals |
max(a,b) + 1ε + 2ε |
6ε |
| inverse |
a + adder + 2ε |
12ε |
| shift left logic |
a + 2ε |
2ε |
| shift right logic |
a + 2ε |
2ε |
| shift left arithmetic |
max(a,b) + adder + 2ε |
15ε |
| shift right arithmetic |
a + 2ε |
2ε |
| no operation |
a + 2ε |
2ε |
Afkortingen:
- a: latency voor stabiel signaal a (Hier: 0ε)
- b: latency voor stabiel signaal b (Hier: 3ε)
- adder: latency van adder (Hier: 10ε)
Besluit
In dit project hebben we een ALU kunnen bouwen. Wat we hieruit kunnen leren is het volgende: Het bekijken van de hoorcolleges gebeurt best zo snel mogelijk. Zo zal je geen fiets moeten heruitvinden, wat we zo goed als overal hebben gedaan. Hierdoor hebben we wel een beter begrip verworven van de leerstof.
Daarnaast zijn we uitgekomen dat de vergelijking van 2 getallen de traagste van de basisoperaties zijn (in onze implementatie weliswaar).
Algemeen besluit van onze 3 projecten
Bij deze projecten hebben we beginnend met de bestudering van basiselementen uiteindelijk een adder opgebouwd, die in onze 16-bit ALU met 16 bewerkingen werd gebruikt. Nu hebben we een basiseenheid voor berekeningen gekregen waarmee we zowel wiskundige basisoperaties kunnen uitvoeren, als logische bewerkingen. Hiermee gaan we in het vervolg manipulaties met gegevens (getallen) kunnen uitvoeren.
Project 4: Memory
Oefening 1: 16-bit register
Hier werd er gevraagd om een 16-bit register te maken met behulp van een flip-flop van type D. We kunnen best beginnen met het bekijken van alle pinnen op een flip-flop. Hieronder vinden we 1 flip-flop element:
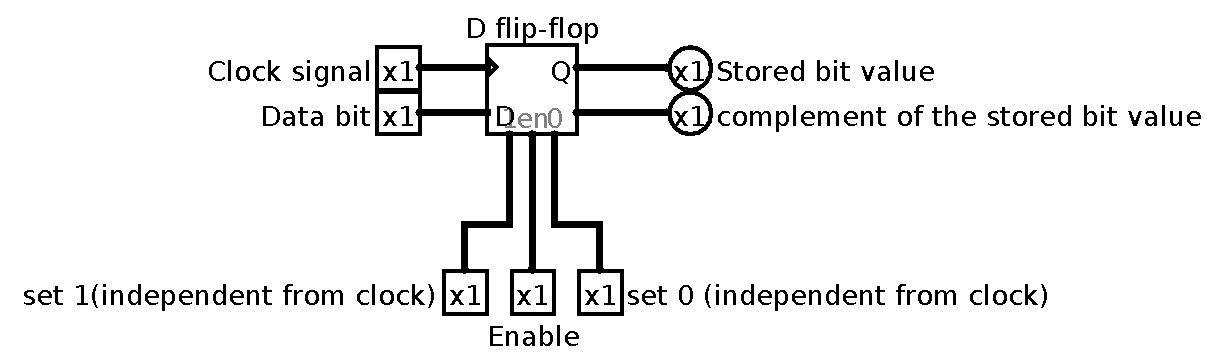
Sommige van de pinnen gaan we niet gebruiken in onze implementatie. Om te bepalen wat we wel en niet nodig gaan hebben, gaan we eerst kijken naar de nodige functionaliteit van ons 16-bit register. We beschouwen deze inputs en outputs in tegenwijzerzin, beginnend met de klok (clock op de tekening)
Het kloksignaal zal ons aangeven wanneer we naar onze flip-flop informatie kunnen doorgeven/stockeren. We werken op de "falling edge", wat betekent dat we de waarde in onze flip-flop kunnen overschrijven als het kloksignaal van 1 naar 0 gaat. Logischerwijze gaan we de klok (clock) wel gebruiken.
Verder hebben we een pin voor "Data bit". Dit is de toestand die we willen doorgeven aan de flip-flop (in het geval dat de flip-flop aan staat, zie verder). Deze pin zal dus ook gebruikt worden.
Verder staat "set 1", wat we in onze implementatie niet gaan gebruiken, omdat we niet plannen om een bit te activeren zonder reden. Dat zal onze eerste niet aangesloten pin zijn.
Een "enable" zal zeker zeer nuttig zijn. Met deze pin gaan we kunnen beheersen wanneer we onze data zouden willen overschrijven en wanneer we die zouden willen stockeren zonder die over te schrijven.
Set 0 is een equivalent van reset (zet alles naar 0), die we ook zeker gaan gebruiken om met 1 signaal alles naar 0 over te schrijven.
Een complement van de gestockeerde waarde is voor ons niet nodig, het geeft ons extra pinnen die we in geval van nood gewoon door een NOT kunnen vervangen. Deze gaan we dus ook weglaten om onze schema's minder ingewikkeld te maken.
Onze laatse pin is de output voor de waarde die in de flip-flop werd gestockeerd, die we zeker nodig gaan hebben.
Om het wat overzichtelijker te maken, gaan we even alle pinnen die we gebruiken oplijsten:
- Clock signal
- Data bit
- Enable
- set 0
- stored bit value
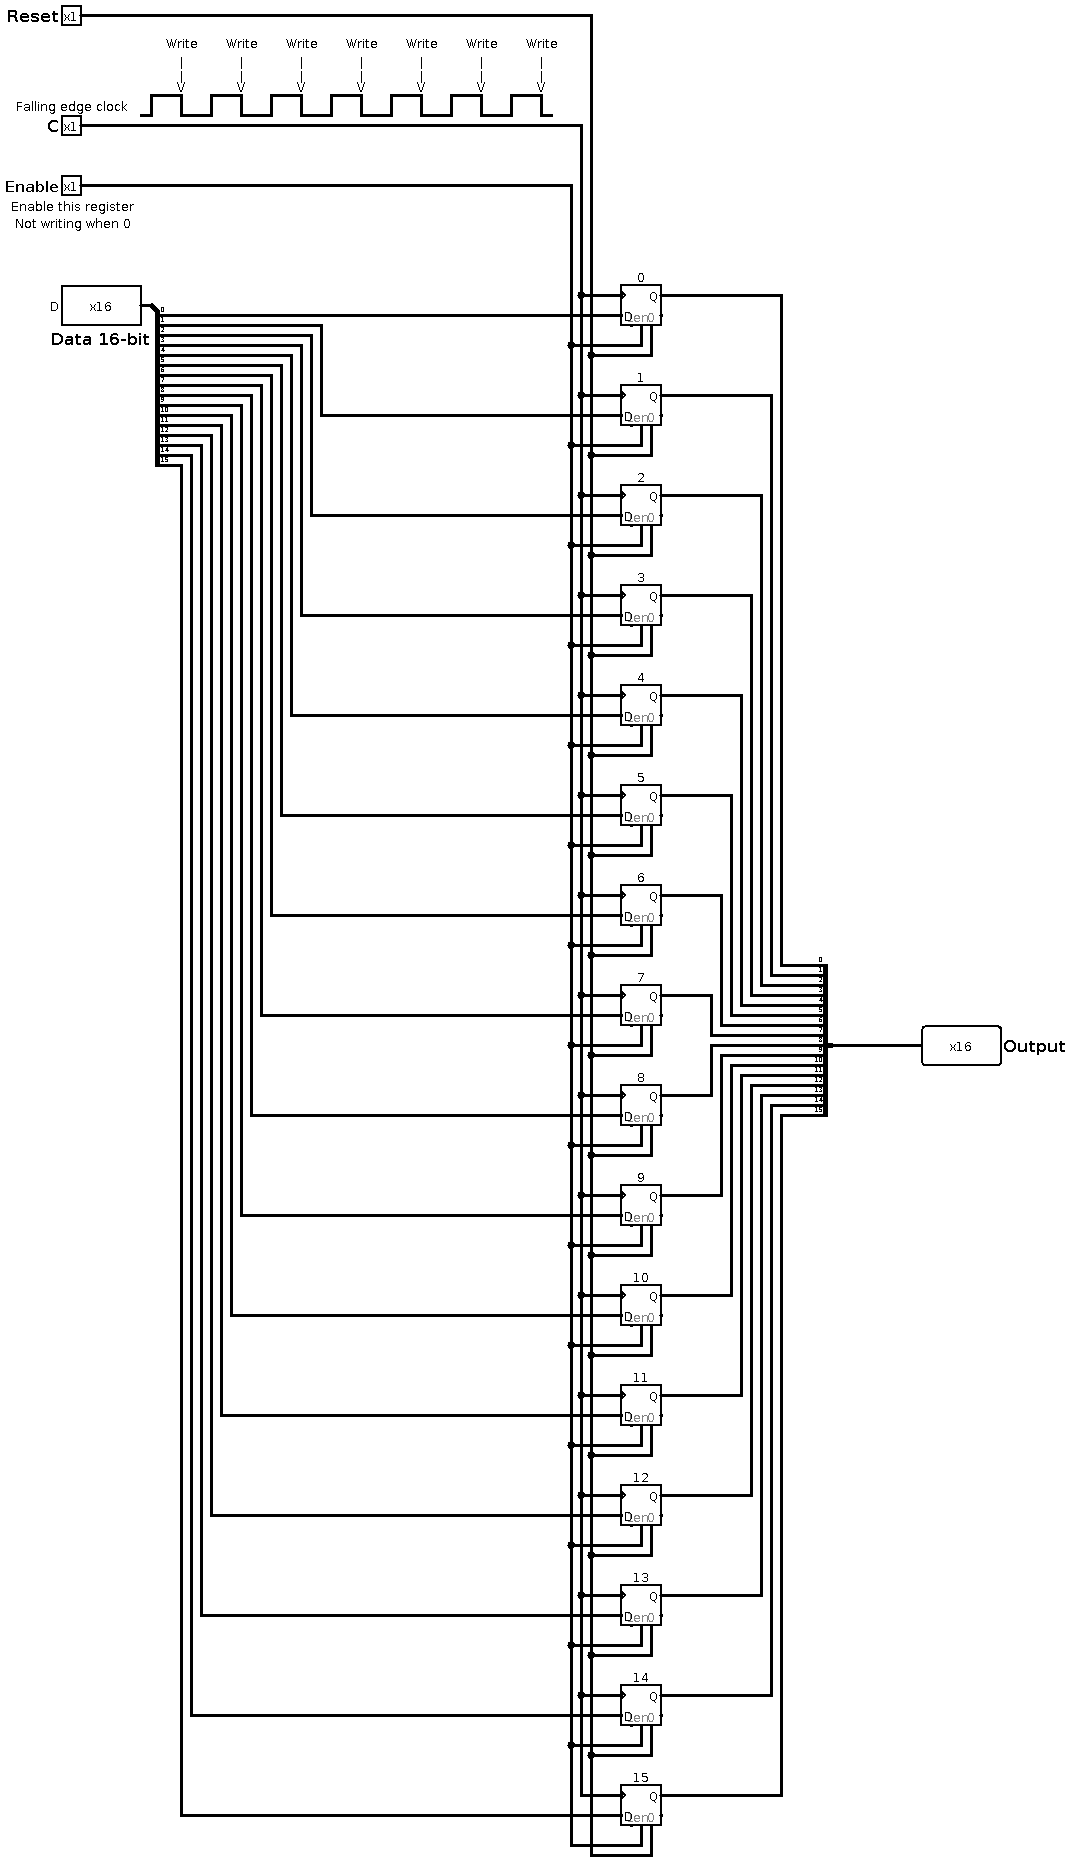
Ons doel is om een 16-bit waarde in te geven en een 16-bit waarde terug te krijgen. Om onze opbouw wat makkelijker te maken delen we de 5 pinnen van de flip-flops in 2 types op. Het eerste type zijn de pinnen met waarden die voor alle flip-flops hetzelfde moeten zijn. Dat zijn namelijk het kloksignaal, het enable-signaal om de hele register in 1 keer aan te spreken en het "set 0"-signaal die het hele register in 1 keer kan resetten. Het tweede type zijn de datapinnen die onderling kunnen verschillen. Volgend schema toont aan hoe we het eerste type en het tweede type anders behandelen in het circuit: Het tweede type krijgt inputs van verschillende lijnen.
Oefening 2: 16-bit register file
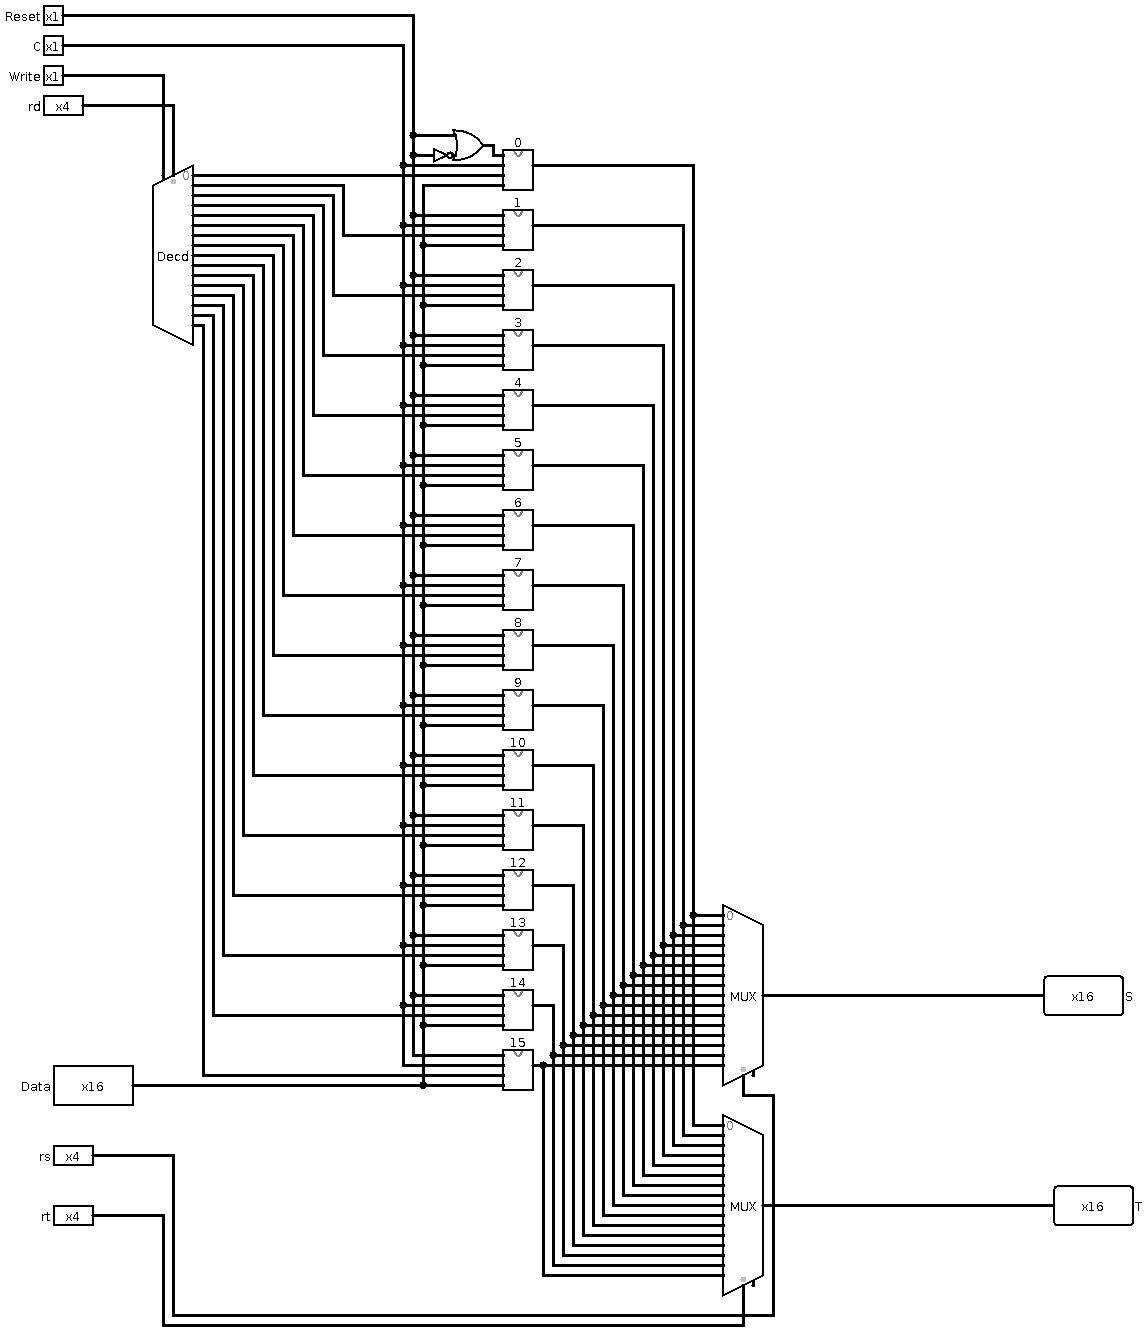
Nu willen we 16 van onze 16-bit registers samenbrengen om meerder waardes te kunnen opslaan. Hierbij moeten we elk register afzonderlijk kunnen aanspreken. Als bijkomende voorwaarden moeten we naar 1 register kunnen schrijven en uit maximaal twee registers tegelijk kunnen lezen. Het eerste waarmee we best kunnen beginnen is alle 16-bit registers nummeren met getallen van 0 tot 15 (dit komt "heel toevallig" best overeen met binaire 4-bit nummering). We gaan dus aan elk 4-bit nummer (verder adres) een unieke lijn toewijzen door een 4-bit decoder gebruiken. In ons eerste concept gaan we de adressen doorgeven op een decoder om ernaar te kunnen schrijven en op twee multiplexors om de twee outputs uit de register file te lezen. Het kloksignaal en de reset zijn een algemene lijn voor alle registers. We moeten enkel opletten met het register op adres 0, want die moet altijd 0000000000000000 genereren. Dit gaan we oplossen door voor de reset pin van deze register een 1-generator te zetten. De inputdata van 16 bits gaan we ook aan alle registers doorgeven, want die gaat enkel in 1 register per klokcyclus overschreven worden. Daarom zijn we niet ongerust dat die iets onbedoeld zal overschrijven.
Het enige signaal dat we nog niet hebben beschouwd is de "write enable". We willen enkel een register overschrijven als we deze activeren. Daarom gaan we met dit signaal de decoder activeren die op zijn beurt een 1-bit signaal genereert op een van de 16 lijnen die elk aangesloten zijn met de "enable" van een 16-bit register.
Nu krijgen we volgend schema:
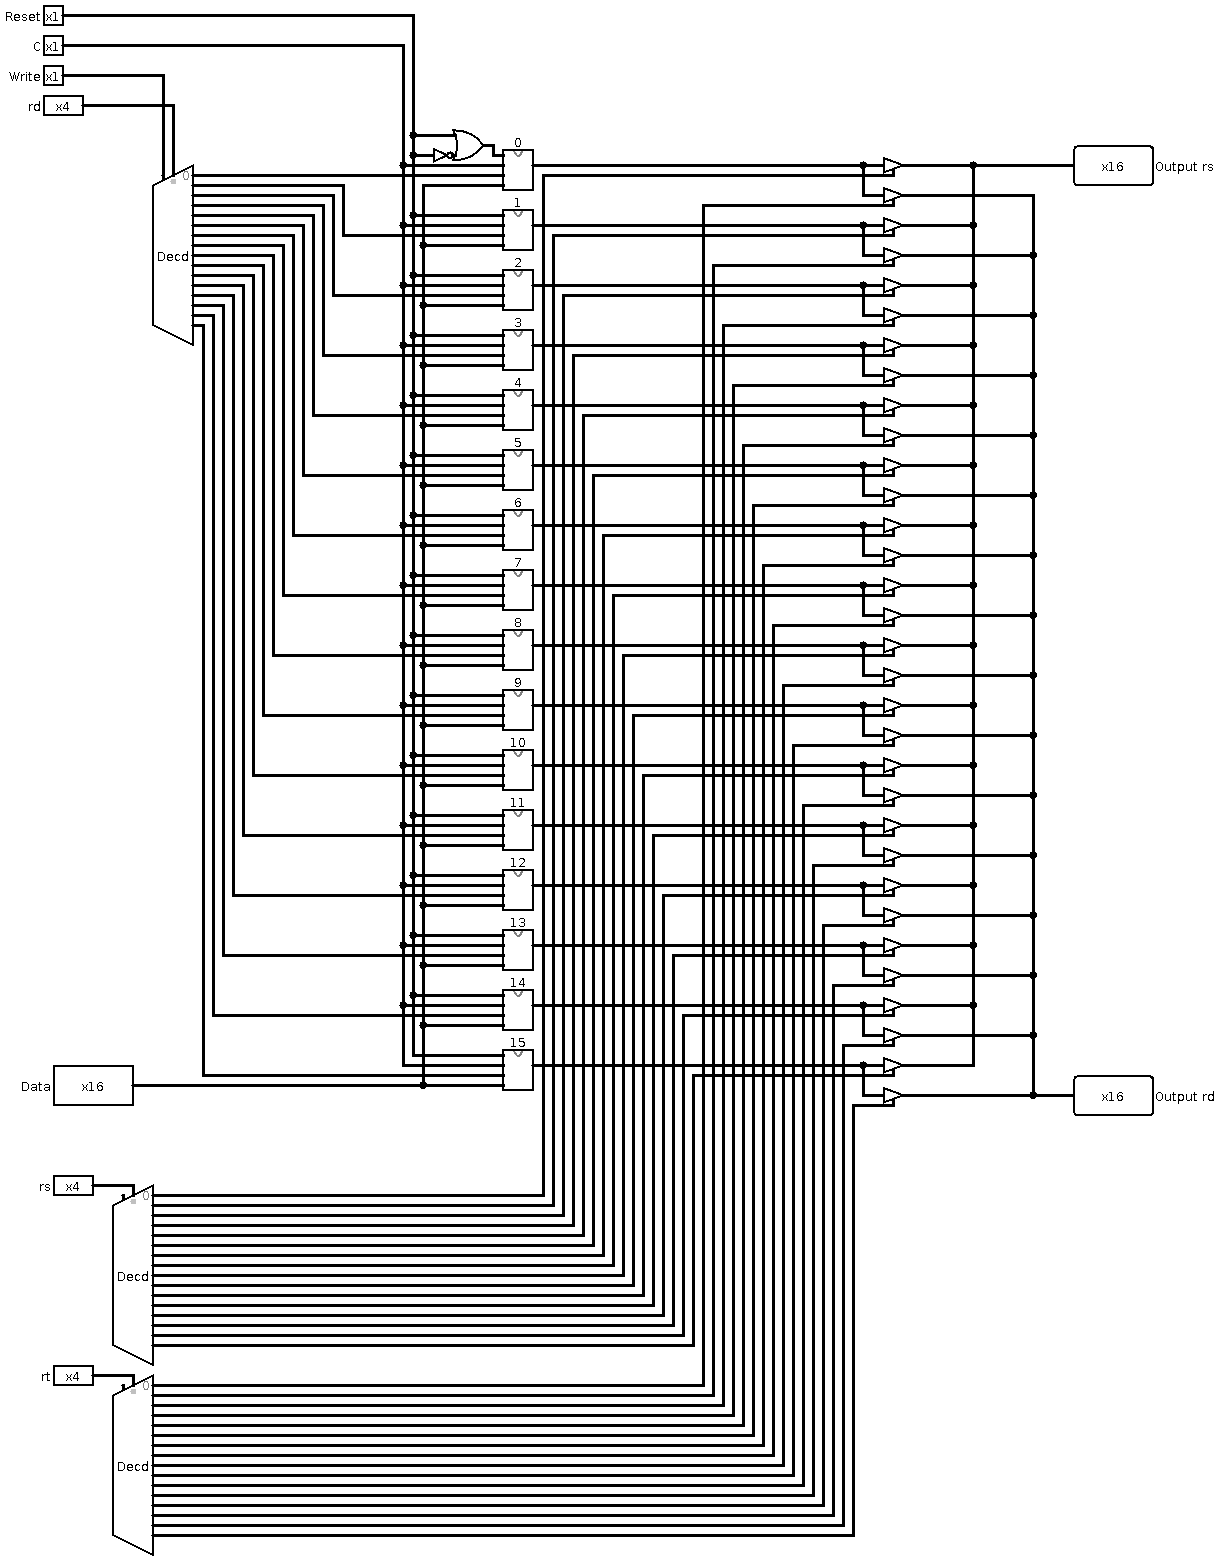
Nu vinden we die multiplexors zeer traag en ze hebben veel elementen nodig voor hun implementatie. Daarom willen we deze twee multiplexors vervangen door twee decoders en een hoop tri-state buffers. De output van de decoders werkt als lijnselector. We krijgen volgend schema als gevolg:
Oefening 3: counter
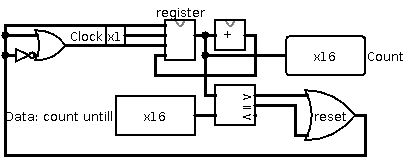
Hoe handig is het als we kunnen nagaan hoeveel klokcyclussen er voorbij zijn gegaan? Natuurlijk, dat is niet gewoon handig, het is van cruciaal belang. Daarom gaan we nu een element implementeren die de klokcyclussen kan tellen. Hiervoor mogen we gebruik maken we van onze 16-bit adder en ons 16-bit register uit oefening 1. Als een kleine bonus gaan we een vergelijkingselement van Logisim gebruiken (en niet omdat onze implementatie zo recht als een sinusoide is, maar omdat het zo in de opgave werd aangegeven).
Om het schema wat compacter te maken gaan we onze adder in een apart element verstoppen die de 16-bit waarde inneemt en diezelfde waarde met 1 opgeteld teruggeeft. Nu kunnen we overgaan naar de logische werking van deze counter.
Het begint met het ingeven van het aantal tellen dat we nodig hebben (in 16 bit natuurlijk). Deze wordt telkens vergeleken met de tijdelijke waarde in de register. Als de tijdelijke waarde kleiner dan de gegeven input is, dan moet enkel de nieuwe tijdelijke waarde geschreven worden in de register. De output van het vergelijkingselement gaan we hier dan ook niet gebruiken. Stel je nu voor dat deze waarden wel gelijk zijn (of zelfs dat de tijdelijke waarde groter is, wat in onze implementatie niet zou kunnen), dan moeten we het register resetten wat direct leidt tot de voorgaande situatie.
Nu willen we nog zien wanneer we de waarde moeten veranderen. Maar dat bepaalt de klok, dus daar zijn we gerust. De andere pin genaamd "write enable" mag van ons dus altijd aan staan want we willen toch elke klokcyclus de waarde veranderen. De output is onze huidige tel die aangeeft hoe ver we zitten.
We krijgen volgend compacte schema.
Oefening 4: finite-state machine
In ons geval gaan we lichten van een verkeerskruispunt met symmetrische tijdsintervallen simuleren. Om te beginnen hebben we een zeer simpel concept geimplementeerd waarbij we maar 1 counter hebben die tot het einde van de cyclus moet tellen. Hierbij gaan we telkens vergelijken met de gegeven eindwaarden voor elke licht apart.
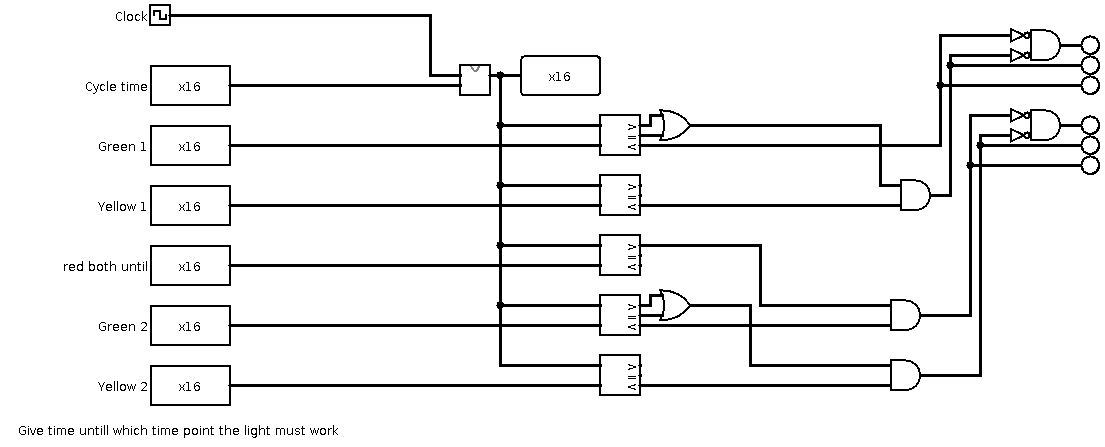
We merken direct dat dit concept te veel inputs vraagt die telkens handmatig moeten worden berekend. Daarom gaan we dit concept lichtjes veranderen. Zoals we eerder hebben gemerkt, zijn de tijden bij beide lichten afwisselend en even lang. Om het wat overzichtelijker te maken gaan we het in een tabel steken en van de tijden weg-abstraheren.
We kunnen in deze tabellen zeer snel regelmatigheden vinden (zeer toevallig). We merken een herhalingspatroon op van 2 lichtpalen die elkaar weerspiegelen, het patroon dat we bij de groene (lees: wisselende) kant zien, kunnen we dan in 3 delen opdelen. Dit betekent dat we al twee counters nodig hebben. Nu hebben we er geen rekening mee gehouden dat de gegeven kleur langer dan 1 tel moet kunnen branden. Dit probleem gaan we dan met de derde counter oplossen.
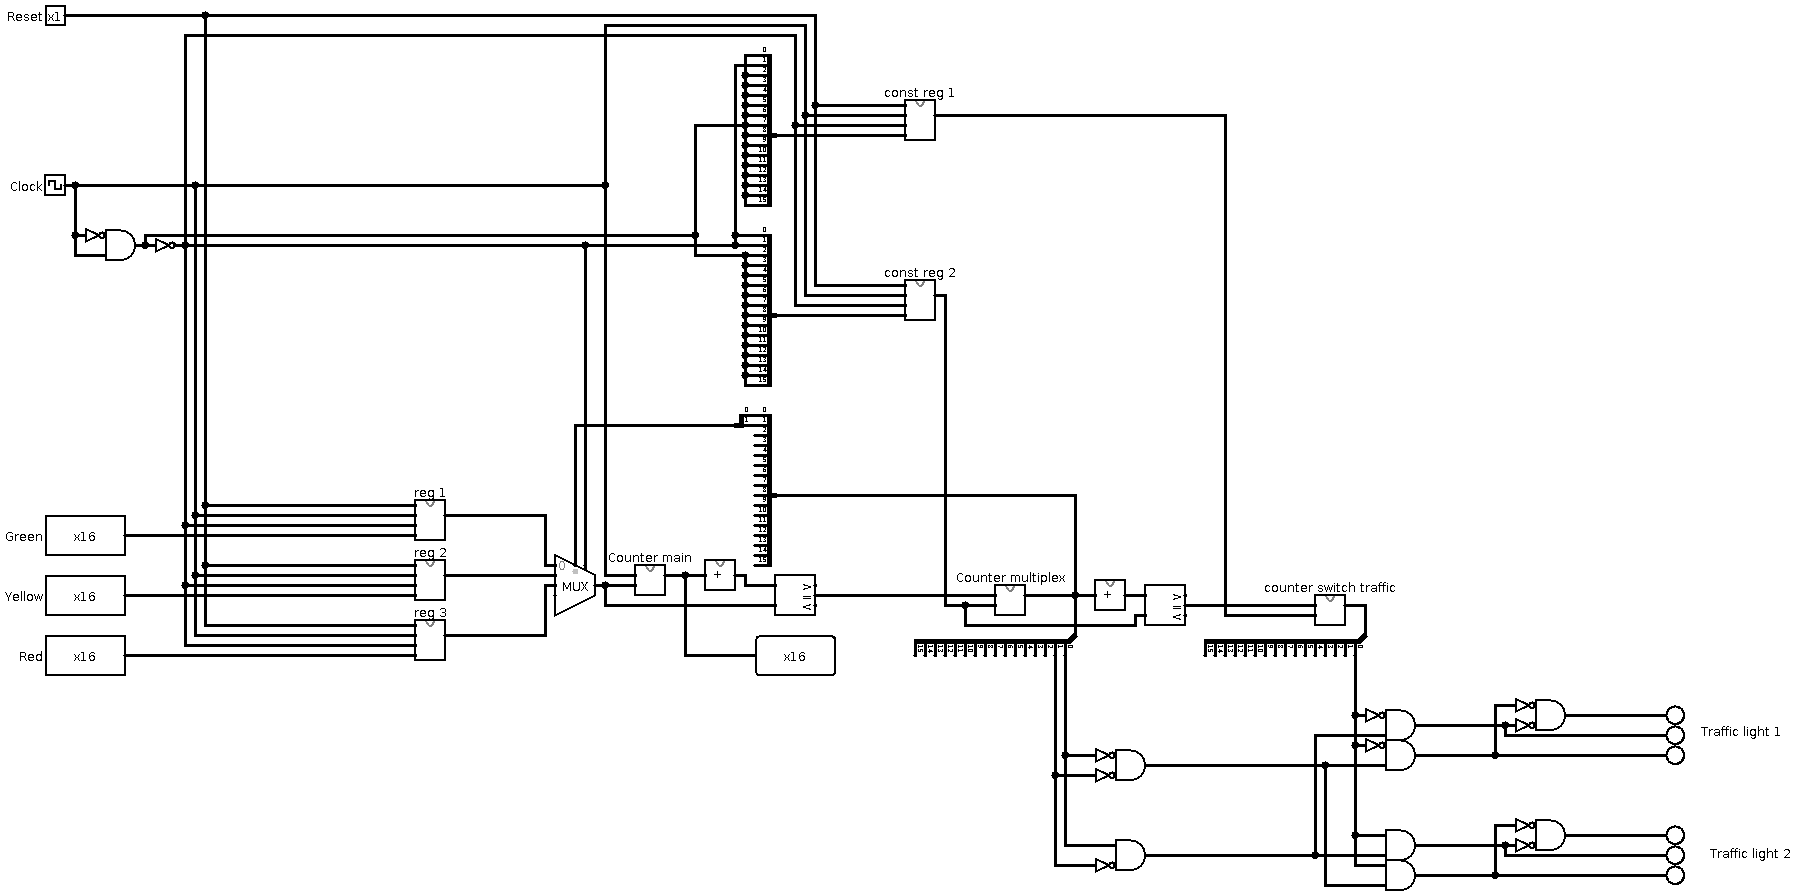
Onze bouw beginnen we met het bepalen van alle nodige inputs. We maken logischerwijze gebruik van een kloksignaal om enige regelmatigheid in onze systeem te hebben (waarom hebben we anders heel dit circus systeem nodig?). De tijdsinterval van elke kleur voor 1 kant geeft ons 3 extra inputs van 16 bits in 2's complement (om zo min mogelijk aanpassingen te maken aan al onze systeem, we konden ook zeker unsigned integers gebruiken in dit geval).
Omdat het altijd en overal een gewoonte is om een reset te plaatsen in het systeem, gaan we deze mainstream dan ook volgen. In totaal hebben we dus 5 inputs nodig, twee van 1 bit en drie van 16 bits.
Omdat we slechts 1 van de drie 16-bit signalen nodig hebben per keer gaan we een multiplexor plaatsen (tri-state buffer kan hier zeker ook een optie zijn). De output van deze multiplexor zal bijgevolg een 16-bit waarde zijn tot waar we moeten tellen. We kunnen hierachter direct een counter plaatsen en een klok eraan aansluiten omdat we hier een interesse hebben in de verstreken tijd. En hier direct achter gaan we een adder plaatsen die een 1 optelt bij de huidige tel, want we beginnen te tellen bij 0 in plaats van 1. En zo kunnen we uiteindelijk een vergelijkingselement gebruiken. We gaan hierbij vergelijken met de waarde tot waar we tellen. Wanneer deze waarde gelijk is aan de waarde na de adder, betekent het dat we de volgende input moeten kiezen. Daarom gaan we bij gelijkheid een signaal doorgeven. Omdat we debielen wiskundigen zijn, gaan we de klokinput van volgende counters misbruiken. We sluiten de gelijkheidslijn van ons vorig vergelijkingselement aan het kloksignaal aan. Van zodra de eerste counter terug begint te tellen van 0, krijgen we op onze tweede counter een falling edge omdat de beginwaarde 1 niet gelijk zal zijn aan de waarde tot waar we hadden geteld. Dit zal ertoe leiden dat de tweede counter 1 tel verder gaat. Dit betekent dat we hiermee het selectiesignaal aan de multiplexor kunnen doorgeven (wat we ook gaan doen).
Met dezelfde logica kunnen we ook de derde counter achter de tweede plaatsen om het juiste licht te selecteren. Om de maximale waarde voor de derde counters aan te maken, maken we een soort van constante registers waar we de waarden aansluiten met behulp van de zero- en 1-generators. De reden dat we de constante registers maken en de lijnen niet direct aan de counters aansluiten, is omdat het anders niet altijd werkte in logisim, in theorie zou dat rechtstreeks aangesloten kunnen worden.
Nu blijft er nog het makkelijkste gedeelte van onze implementatie over. We kunnen het signaal van de tweede counter gebruiken om de juiste kleur van het licht te kiezen via 2 AND poorten. Uit de derde counter kunnen we dan de selectie maken welke van de twee lichten moet veranderen.
Uiteindelijk krijgen we volgende mooie schets van ons circus systeem.
Spoiler: Schema
Project 5: Datapath
In dit project gaan we een simpel datapad implementeren. Dit betekent dat ons datapad nog geen verplaatsingen in de instructie-RAM kan uitvoeren. Om zo een datapad te implementeren maken we eerst een aangepaste program counter (PC, niet verwaren met Personal Computer).
Deel 1: Onze Geiger program counter
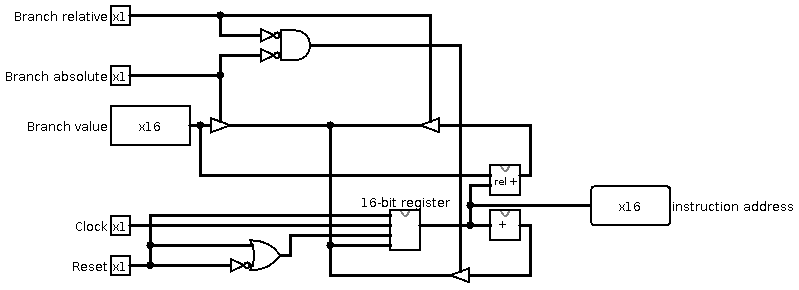
Aan de basis van dit element ligt de counter uit project 4, die natuurlijk lichtjes werd verwerkt. We hebben ook direct een branch relative(br) en branch absolute(ba) toegevoegd, ook al wordt er in dit project geen gebruik van gemaakt.
Eerst moeten we zien dat er een onderscheid wordt gemaakt tussen 2 branches en een gewone telling. We weten dat ba en br nooit allebei 1 zouden kunnen zijn, we hebben daarvoor dus ook geen aparte lijn. Dus we onderschijden ba en br met elk een apart lijntje naar een eigen tri-state buffer. In het geval dat beide 0 zijn moeten we een gewone teller gebruiken, dit beteken dat we een derde tri-state buffer kunnen plaatsen die door een AND zal woorden aangestuurd waar beiden, ba en br, 0 zijn.
Het adres van huidige instructie wordt opgeslagen in een 16-bit register. Welke inputdata's zijn er dan mogelijk? Het absolute adres gaat er rechtstreeks in, de relatieve via de adder van het huidige adres met de realtieve waarde in 2's complement met 1 opgeteld en als laatste gewoon het huidige adres vergroot met 1. De keuze van de huidige waarde zal dan via de omschrijving in vorige alinea gebeuren.
Als een kers op de taart gaan we een klok en een reset aansluiten aan ons systeem die nodig zijn voor ons 16-bit register. Omdat onze waarde in het register elke cyclus zou moeten veranderen, plaatsen we een 1 generator voor de write enable van onze register.
Uiteindelijk krijgen we volgend schema:
Deel 2: "Houston, we have a problem" - of onze implementatie van datapath
We zijn eindelijk geraakt aan onze implementatie van het datapad. De opbouw ervan ging in een aantal stappen, die we gaan overslaan en direct een kijkje gaan nemen naar ons uiteindelijke schema.
De opbouw van ons datapad begint met het plaatsen van 2 RAM-geheugens en 1 16-bit file register, die we hadden aangepast voor deze opdracht (Dat wordt als laatste besproken). Alle RAM-geheugens krijgen zelfde input binnen in het begin van ons testprogramma, maar de inputgegevens hebben verschillende functies, dus gaan we deze onderverdelen in verschillende categorieen. De 2 RAM-geheugens gaan we opdelen volgens hun functie. Het eerste RAM-element gaan we gebruiken om instructies uit te lezen. Het tweede zal gebruikt worden om data uit te wisselen en te stockeren.
Ons eerste deel van het schema bevindt zich voor de instructie-RAM. Hier plaatsen we een PC waarvan de output het adres in de instructie RAM gaat aanduiden. Bij de instructie-RAM gaan we ook op de pinnen "select" en "load" een 1 generator aansluiten. Op de PC moeten we een klok en een reset aansluiten. Bij de branch relative en absolute gaan we hier een 0 generator plaatsen omdat we dit stuk niet gaan implementeren. De branch value van PC gaan we gewoon uit de output ervan nemen. Het wordt hier toch niet gebruikt, maar dit zal wel nodig zijn in het volledige datapad, dat we in volgende projecten gaan implementeren. Zo krijgen we uit dit stuk een instructie terug die op het uitgerekende adres staat.
In volgend stuk overlopen we alles wat er zal gebeuren tussen de instructie-RAM en de 16-bit file register. We beginnen bij de instructie die uit het instructie-RAM komt. Deze wordt opgesplitst als volgt: Een 4-bit operatiecode, 4-bit register 1, 4-bit register 2 en 4 bit register 3 of een offset. De gebruik en bedoeling van deze registers en wordt door de instructieset bepaald. We hebben onze set in vier types instructies ingedeeld. Dat ziet er als volgt uit:
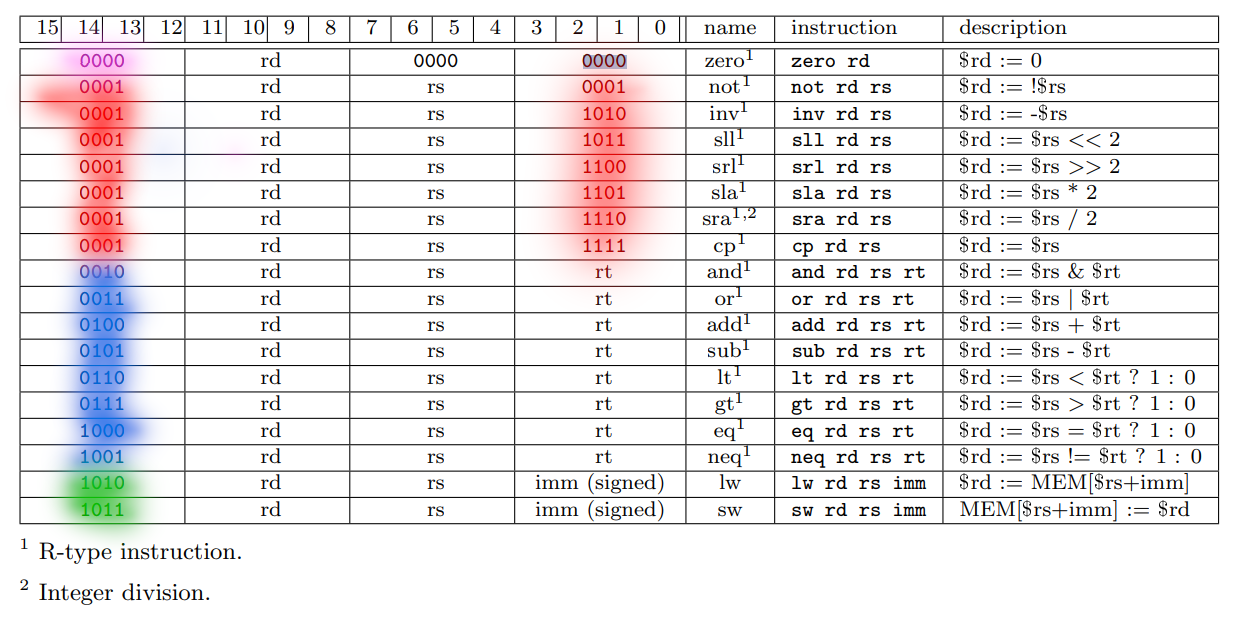
We beginnen met het eerste type, dat enkel uit de "zero" operatie bestaat. De eerste 8 bits definieren deze operatie al: we willen een 0 op het aangegeven register.
Het tweede type instructies zijn die met de ALU code in de laatste 4 bits. Om dit aan te geven wordt de opcode 0001 gebruikt. Dit zijn operaties die slechts op 1 waarde de bewerking uitvoeren.
Het derde type zijn operaties die met 2 waarden een bewerking uitvoeren, met de ALU code op eerste 4 bits.
Het vierde type zijn memory operaties die te herkennen zijn aan de offsets. Deze hebben een gelijkaardige opcode waarbij slechts 1 bit verschilt.
Waarom deden we zoveel moeite om deze opsplitsing te doen? Het blijkt dat we een aantal gevallen moeten onderscheiden, waarbij we verschillende delen van instructie en verschillende elementen gaan gebruiken. Zo hebben we voor de eerste drie types een ALU nodig die een waarde zal teruggeven om die rechtstreeks naar het file register door te voeren. Het vierde type zal uit de ALU een adres krijgen om met de data-RAM te werken. In het eerste geval gaan we eruit lezen, in het tweede ernaar schrijven. De bedoeling van alle tussenliggende verbindingen is makkelijk af te lijden leiden.
Spoiler: Schema Datapath
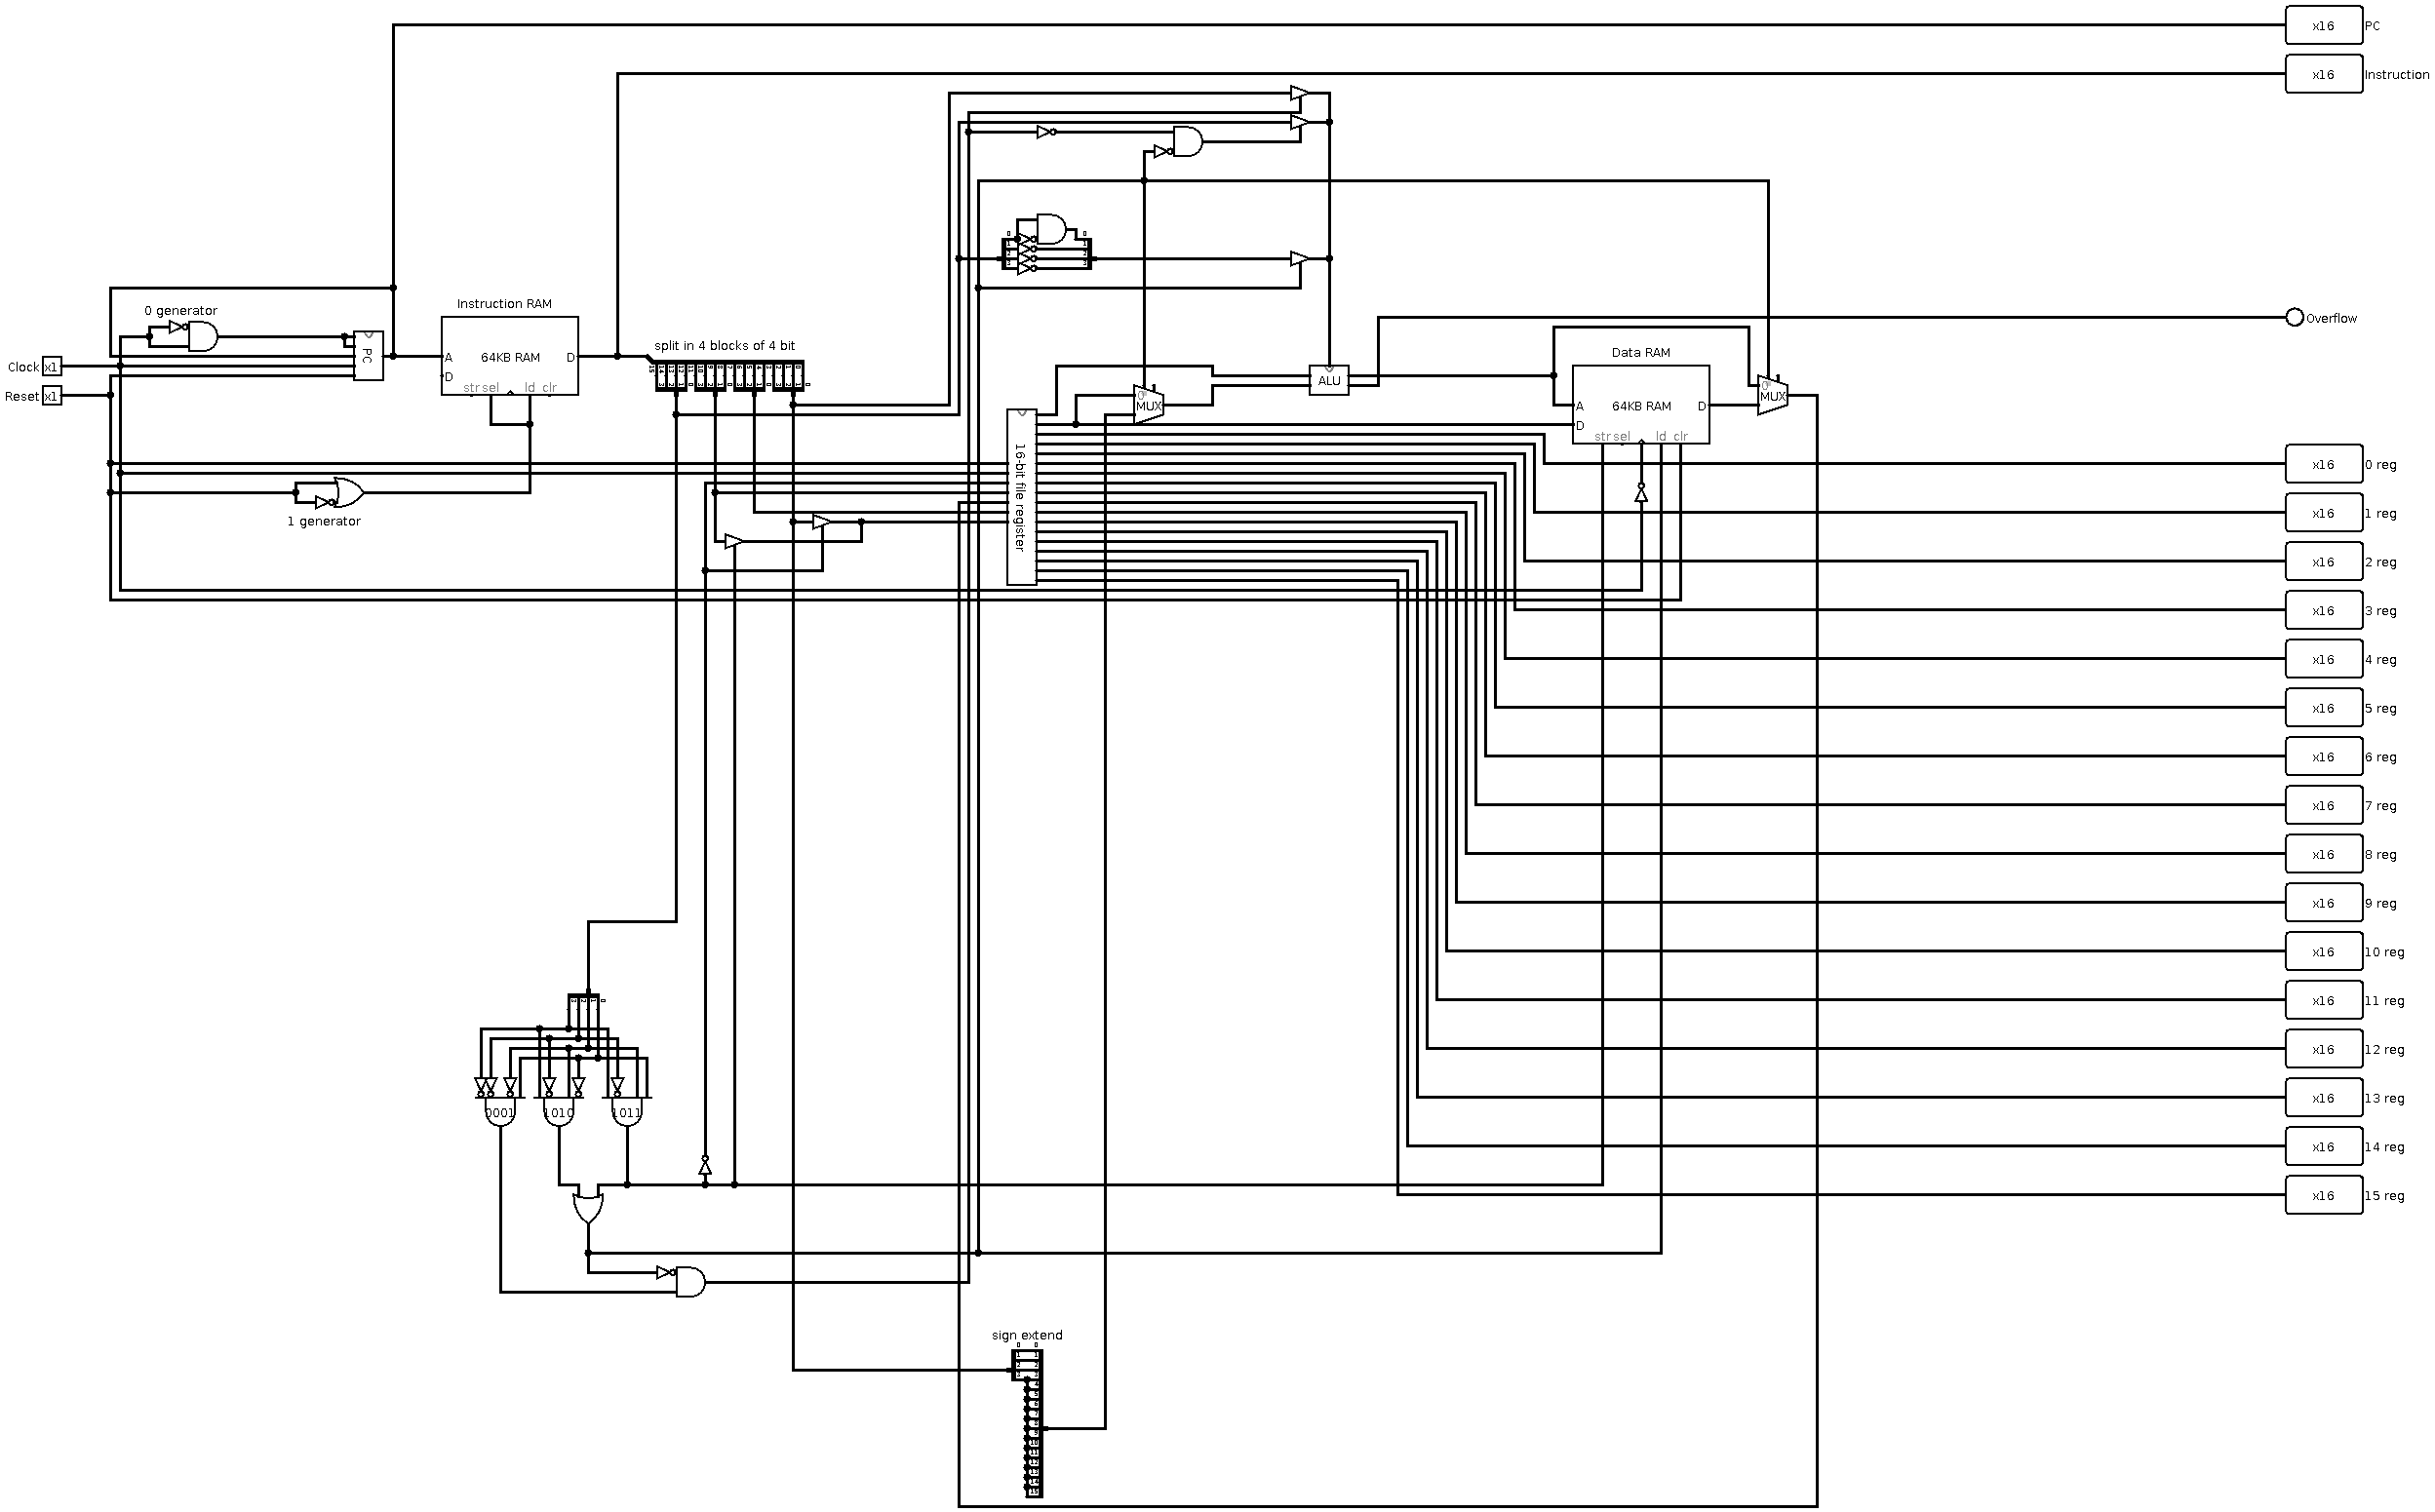
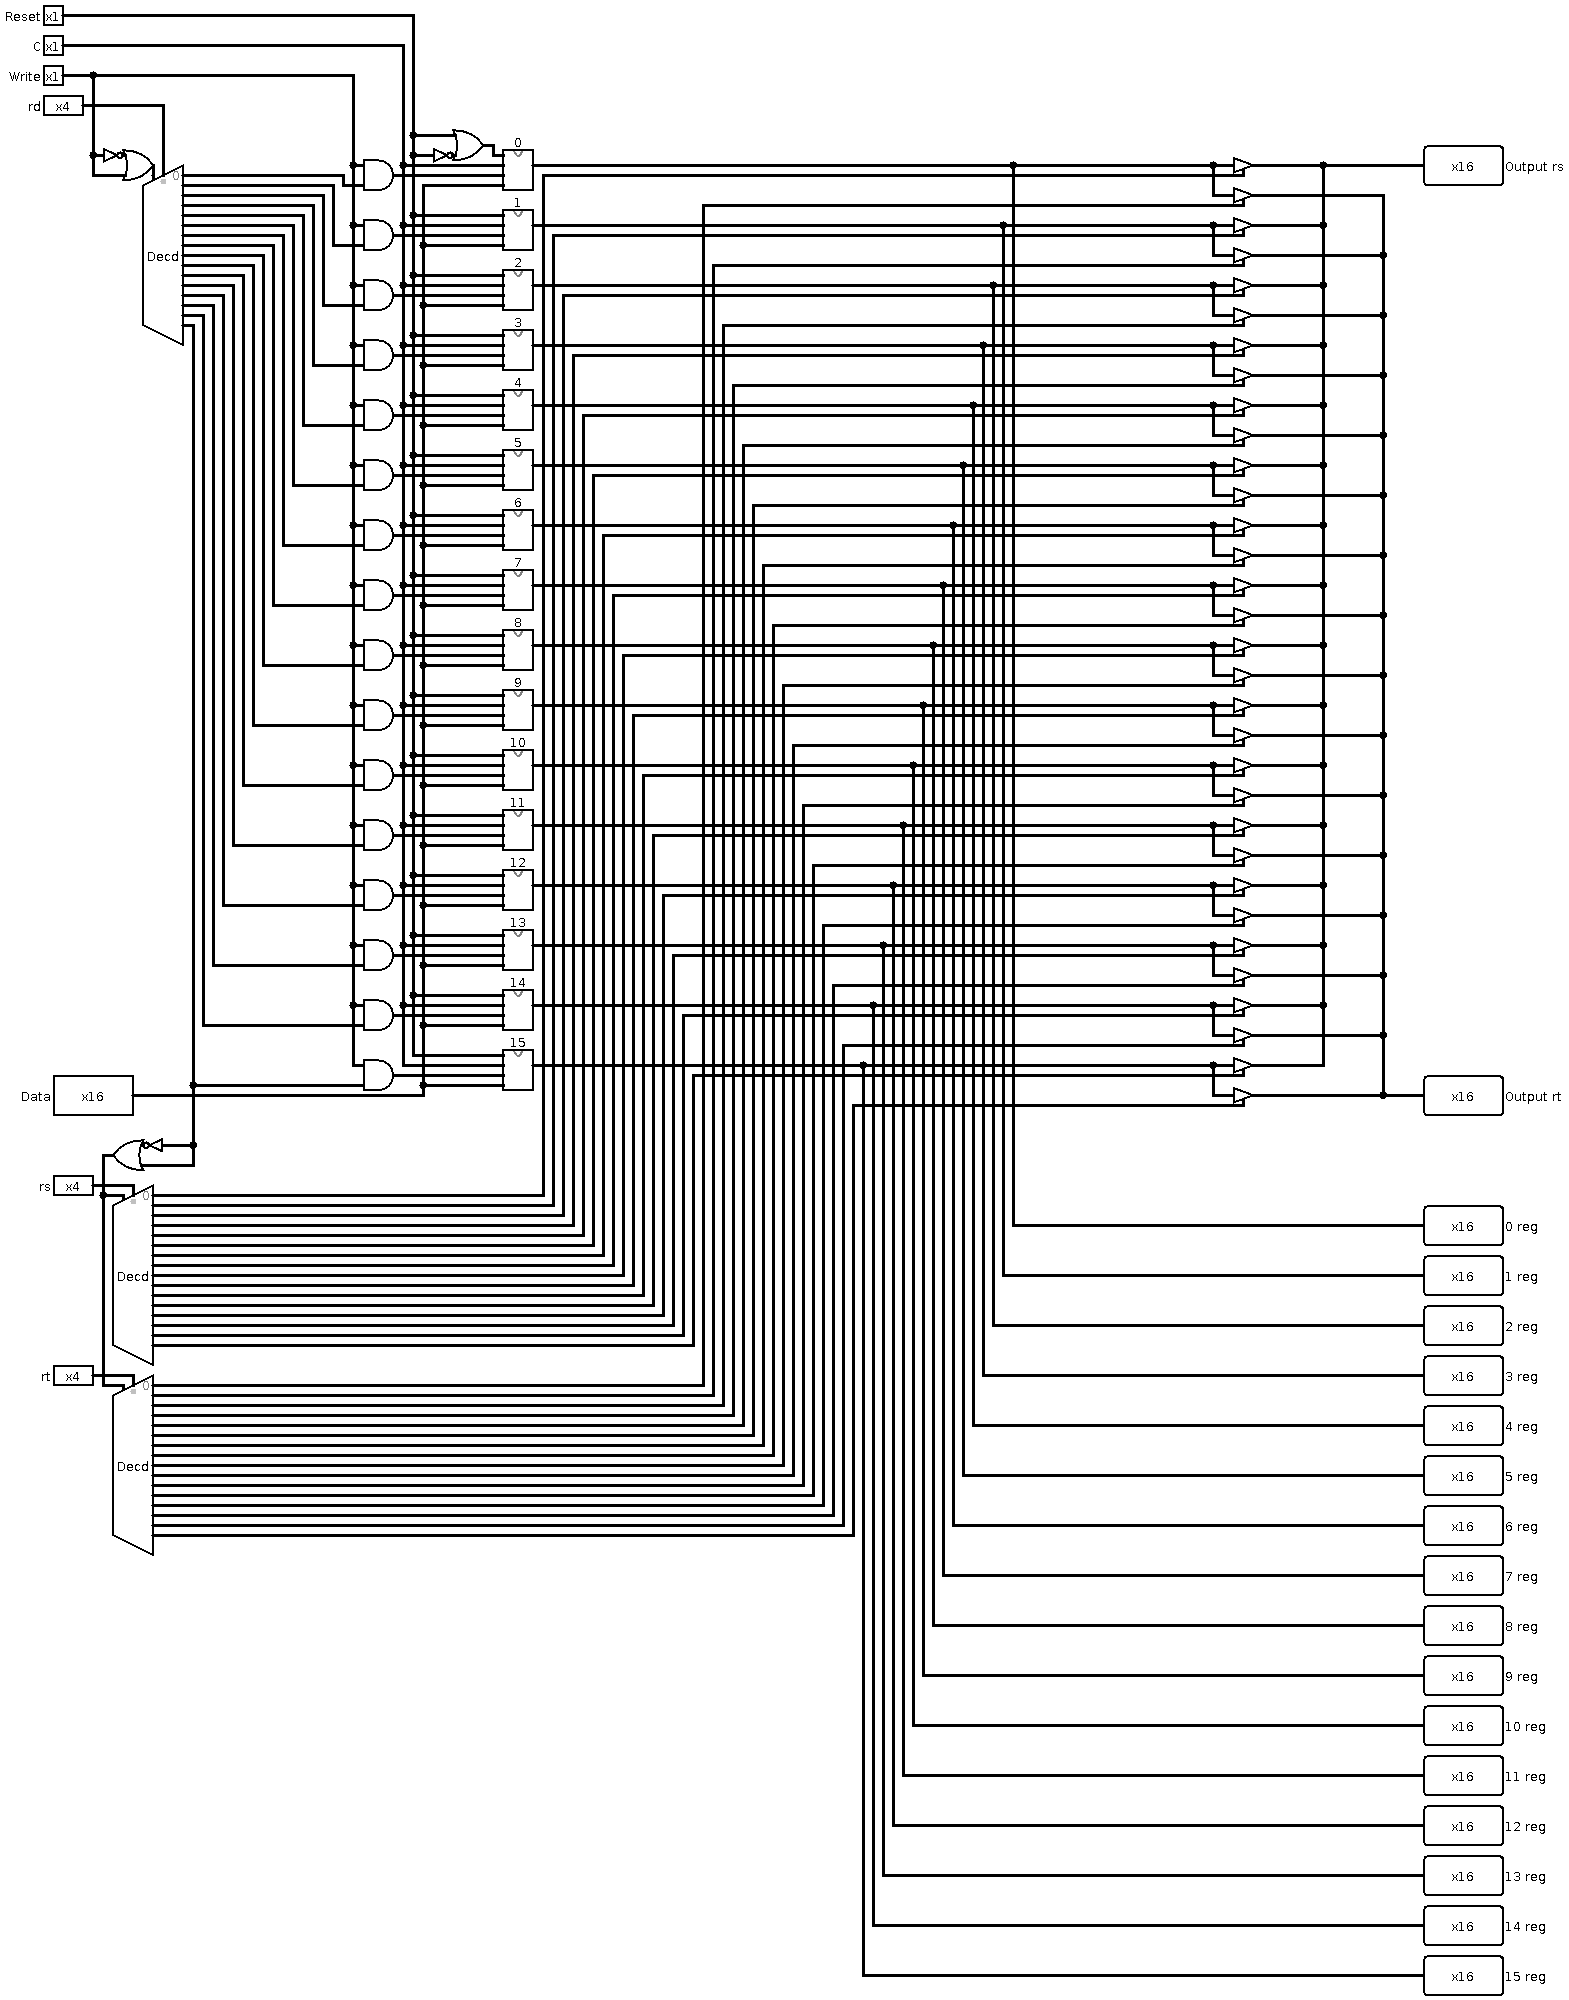
Ons schema is klaar, tijd om te testen. En als iemand denkt dat deze frankenstein tot leven is gekomen, dan denkt die fout. Het bleek dat onze operatie "sw"(naar de data-RAM schrijven) niet werkte. Uiteindelijk zijn we beland op een kleine onnauwkeurigheid in ons vorig project. Omdat we hadden verondersteld dat het overbodig was om de multiplexors constant aan te laten staan, waren de file registers niet aangesloten op het moment dat de overschrijving gebeurde. Dat hebben we opgelost door een 1 generator te maken en deze aan alle multiplexors aan te sluiten. Daarbij moesten we wel voor elk register een AND met de write enable verbinden. Alweer, op een schema zal het direct duidelijk worden. Voor de testen werden er ook extra outputs toegevoegd van elk register, maar dat is niet zo spectaculair.
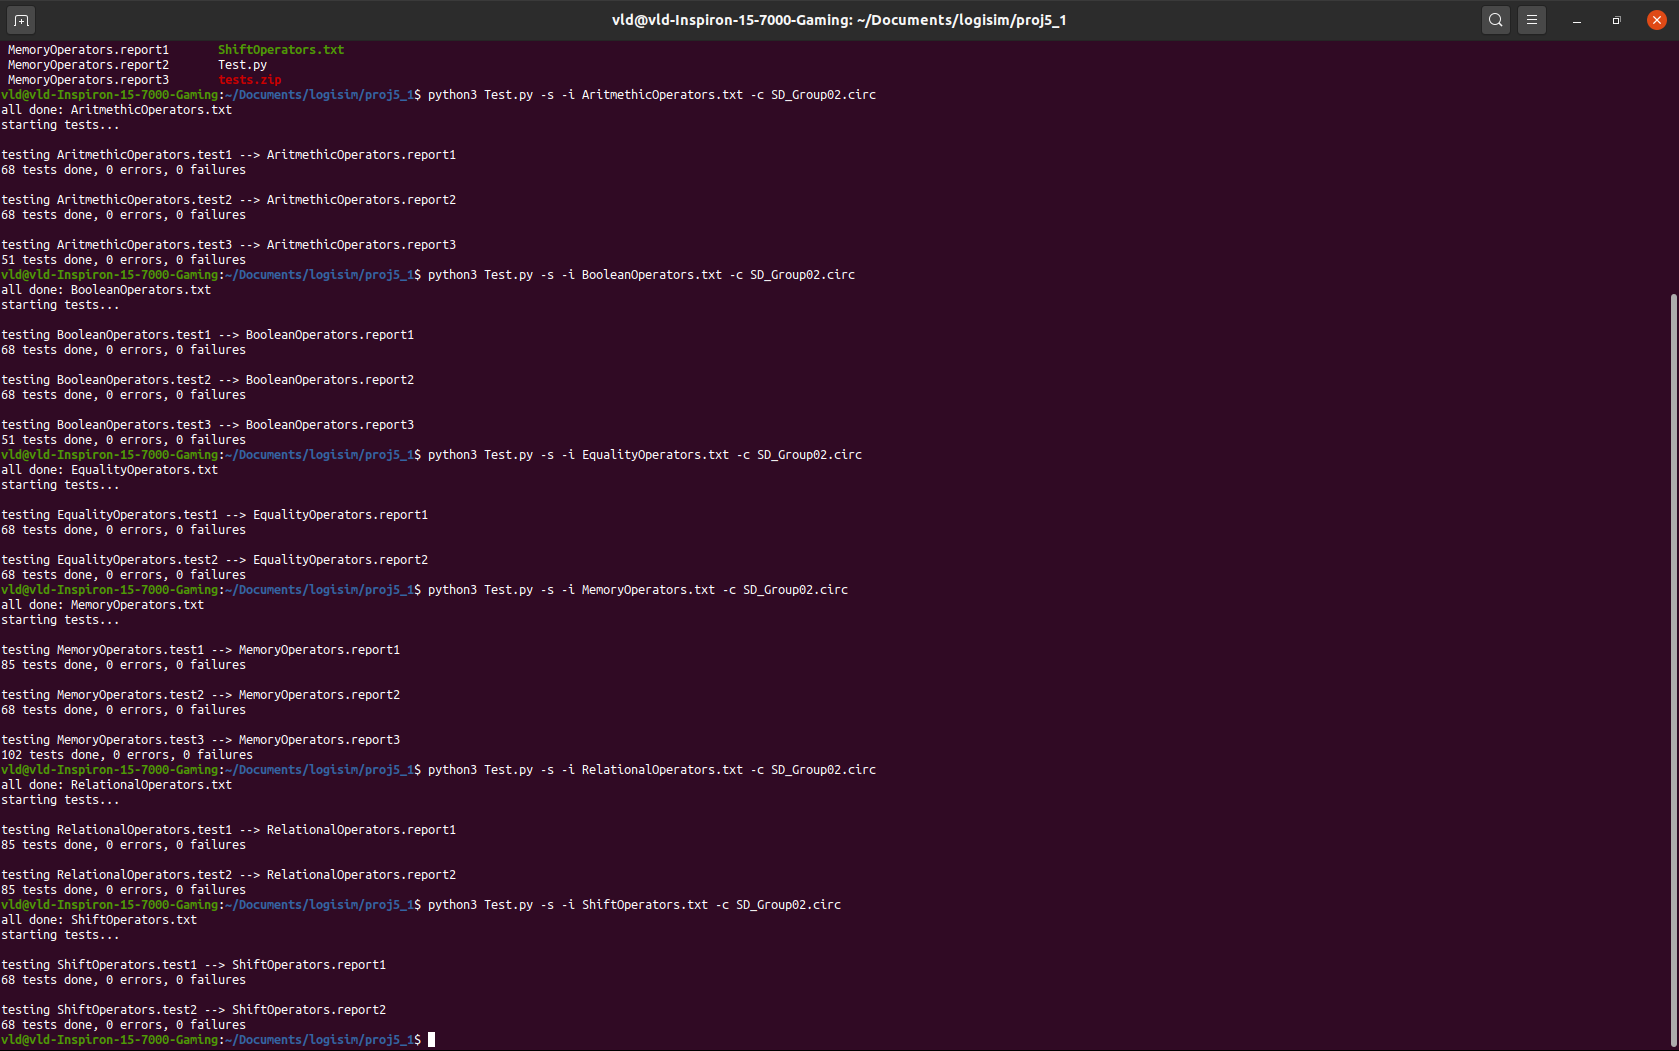
En nu konden we eens onze testen doen. Natuurlijk met een positieve resultaat want negative resultaat maal depressie geeft een positieve resultaat. Net zoals vorig keer, kwam er veel blijdschap met het volgende scherm.
Algemeen besluit van onze 5 projecten
Oorspronkelijk waren we begonnen met het bekijken van 3 logische elementen. Hieruit hadden we uiteindelijk een ALU geimplementeerd. Dan zijn we op zoek gegaan naar een manier om een waarde van 1 bit te kunnen behouden. Hierbij hebben we alweer enkel onze 3 logische elementen gebruikt. Hierbij hebben we een flip-flop gezien. Hieruit hebben we registers en register files gemaakt. Met behulp van onze eigen ALU en register file hebben we een simpel datapad geimplementeerd. Nu kunnen we op dit datapad simpele programma's schrijven zonder loops of condities.
Project 6: Full Datapath
In vorige project hebben we een werkende datapath geimplementeerd. Die kon met onze ALU werken, naar het RAM sschrijven en uit het RAM lezen. Hiermee kunnen we berekeningen doen, die saven en later terug hergebruiken. Dit zijn dus heel rechtlijnige programma's die we kunnen maken. We moeten hierbij wel elke stap handmatig uitschrijven want we kunnen nergens stukken van programma hergebruiken. Dat heeft meerdere problemen als gevolg. De meest triviale ervan zal herhaling van code zijn en onmogelijkheid om stukken code over te slaan als ze niet nodig zijn.
In deze project gaan we deze probleem oplossen. Hiervoor gaan we wat instructies toevoegen voor gewone en conditionele sprongen. We gaan twee instructie toevoegen die de waarde direct uit commando kunnen halen om die in de berekeningen te kunnen gebruiken, wat we vorig keer enkel deden om de relatieve adressen in RAM geheugen te bereiken.
Om minder elementen op onze schema te hebben, werd er beslist om een aparte circuit te maken, die de instructie opsplitst. Na de spitsing kunnen we de instructie "analyseren" met behulp van onze logische poorten (basics are always powerfull). De belangerijkst outputs zijn de selectiekanalen voor multiplexers en de 16 bit output die afhankelijk avn de instructie als een getalwaarde of als adres gebruikt kan worden. De hoofdprincipe bij opbouw ervan was om de gelijkaardige instructies bij elkaar te zetten en daarna speciefiek alke mogelijkheid na ta gaan.
Trouwens dat kind heeft ook een naam gekregen en wordt de "control unit" genoemd. Om enig voorstel te hebben wat we erbij moeten voorstellen is de geboortefoto hieronder:
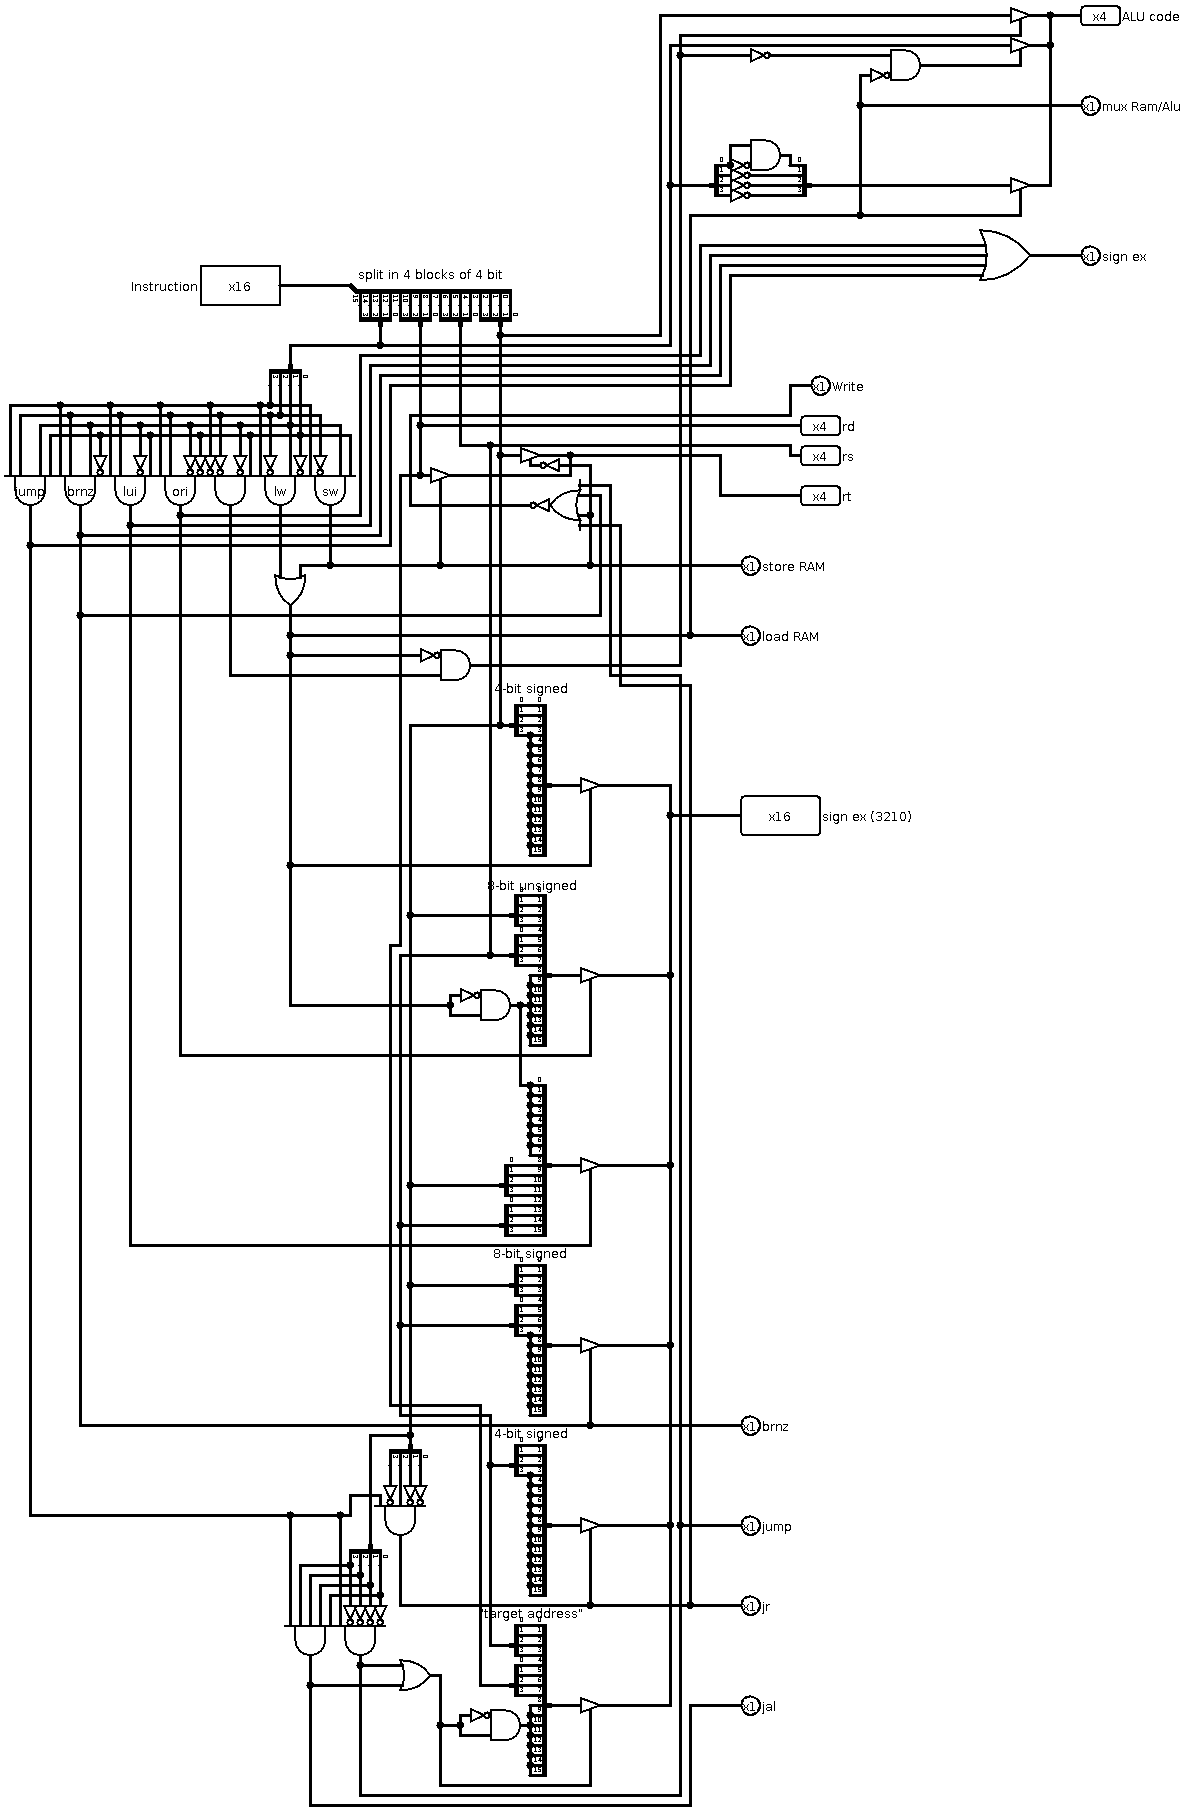
Nu onze control unit gebouwd is moet die ook iets kunnen controleren (anders moesten we het een betere naam geven natuurlijk). Daarom gaan we in onze datapath alle elementen die naar de control unit hebben gemigreerd weglaten.We gaan beginnen met de makkelijkste ansluitingen. De ALU code die onze control unit genereert mag rechtstreeks worden aangesloten. De selectielijnen van de multiplexers mogen ook rechtstreeks worden aangesloten. De selectie van de juiste registers gebeurt ook in onze control unit dus sluiten we de rd, rs en rt rechtstreeks aan onze file register volgens onze labels. Voor write, store RAM en load RAM gebruiken we zelfde makkelijke principe van aansluiting. Al de rest van de outputs wordt op een spaghettimanier iets ingewikkeldere manier aangesloten. Enige output dat we nog speciefiek zouden willen bekijken, is de 16 bit output. Die heeft geen vaste naam want afhankelijk van instructie wordt die op verschillende manieren geinterpreteerd. Dat is de voornaamste reden dat er nog heel wat logische poorten zich buiten de control unit bevinden. De datapth zal zoals altijd door de grootte in een spoiler zitten.
Spoiler: Schema full datapath
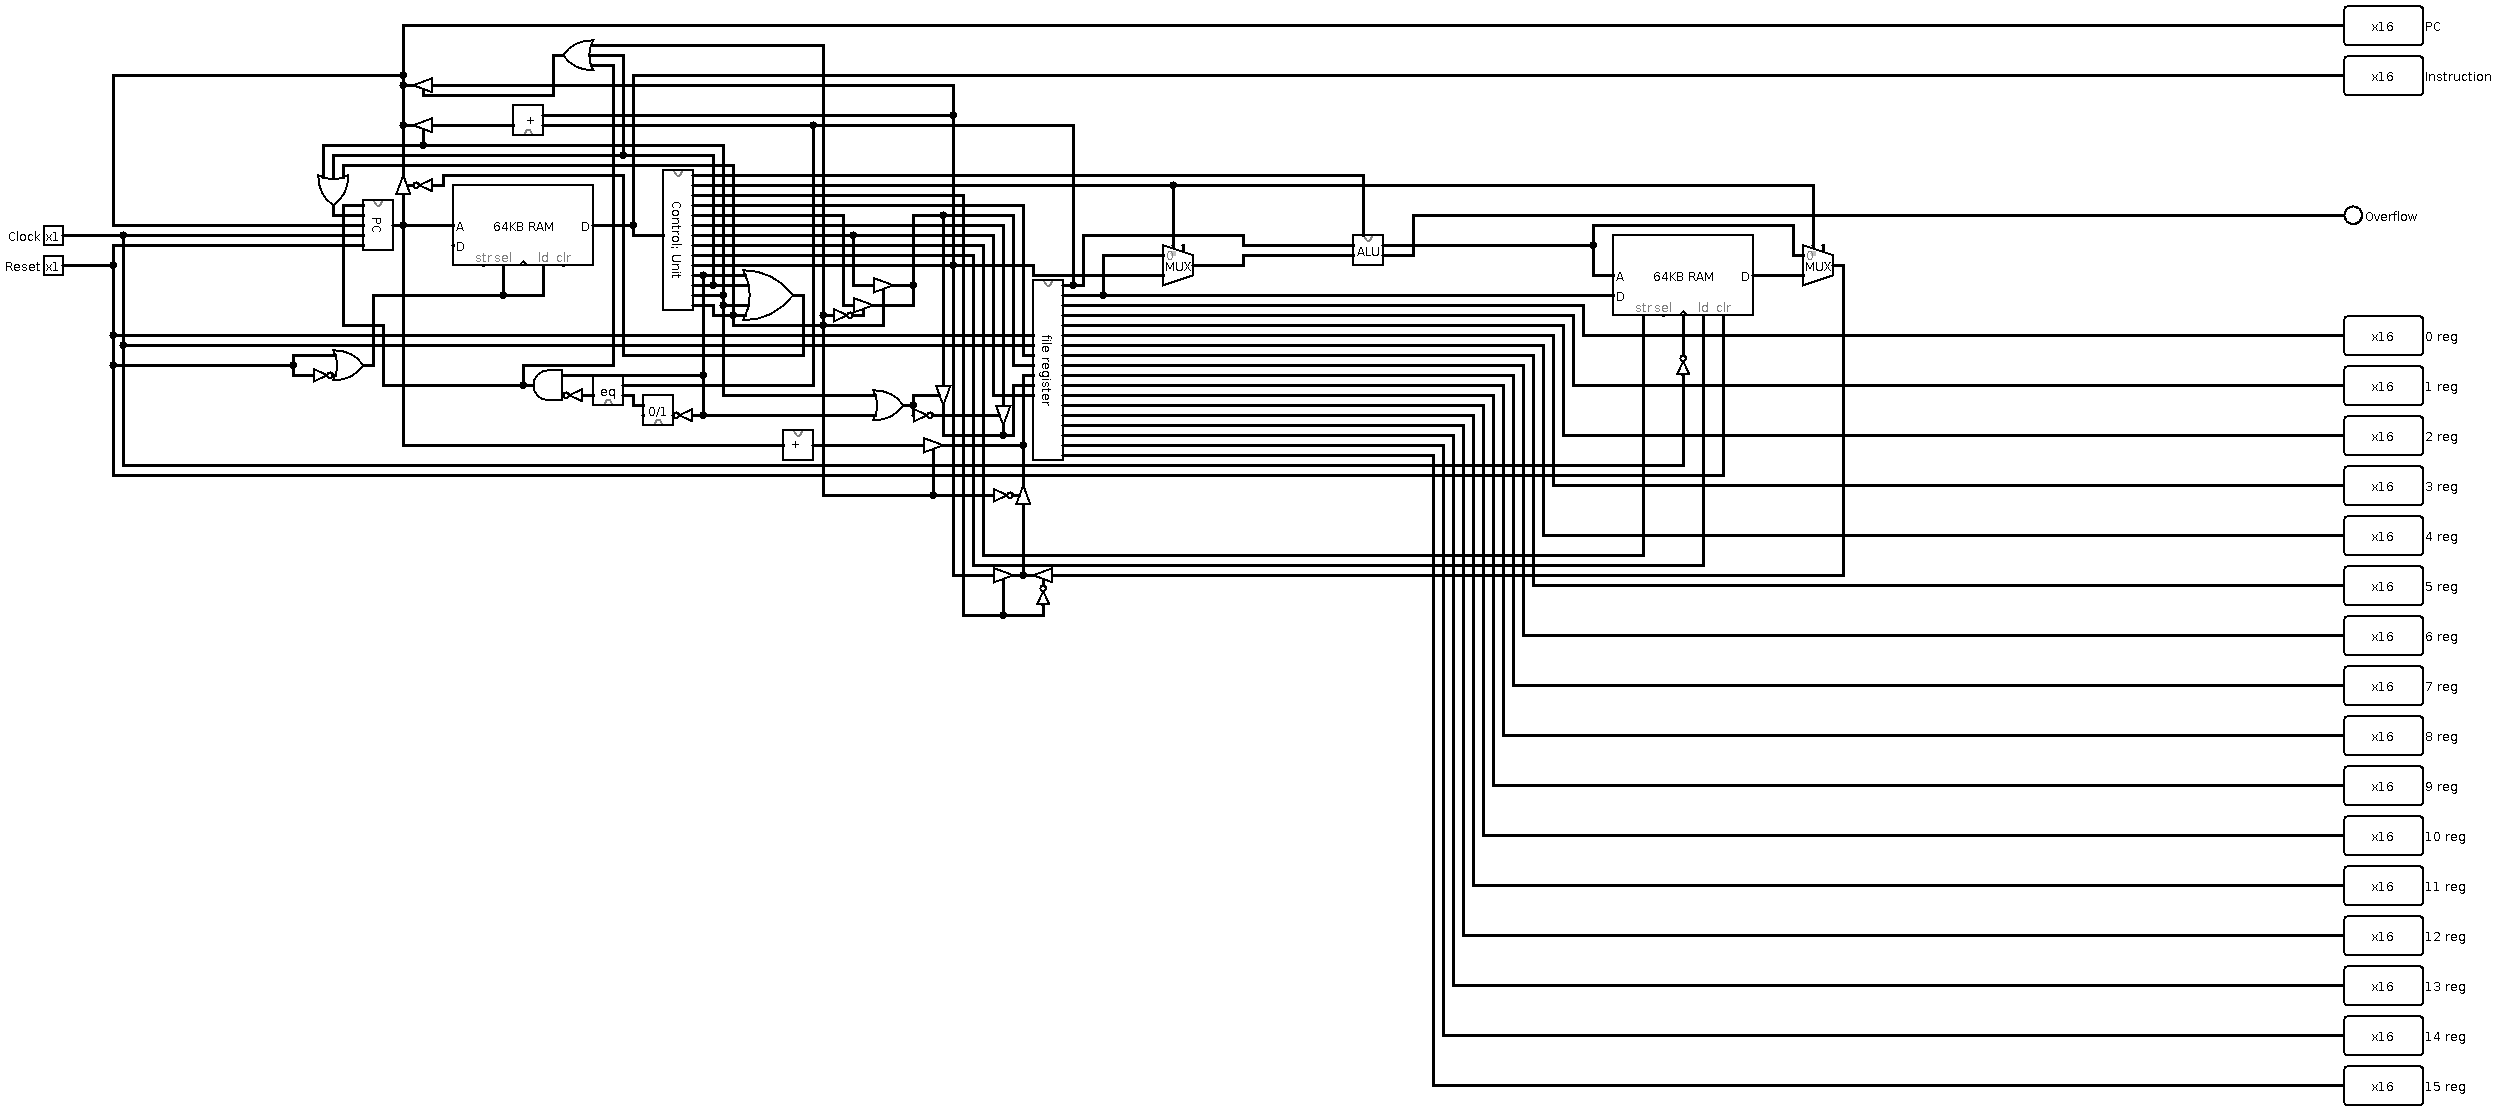
Nu kunnen we overgaan naar de testen van deze schema. Het was wel nodig om even te puzzellen maar het is uiteindelijk gelukt om volgende scherm te krijgen.
Spoiler: Exception schema
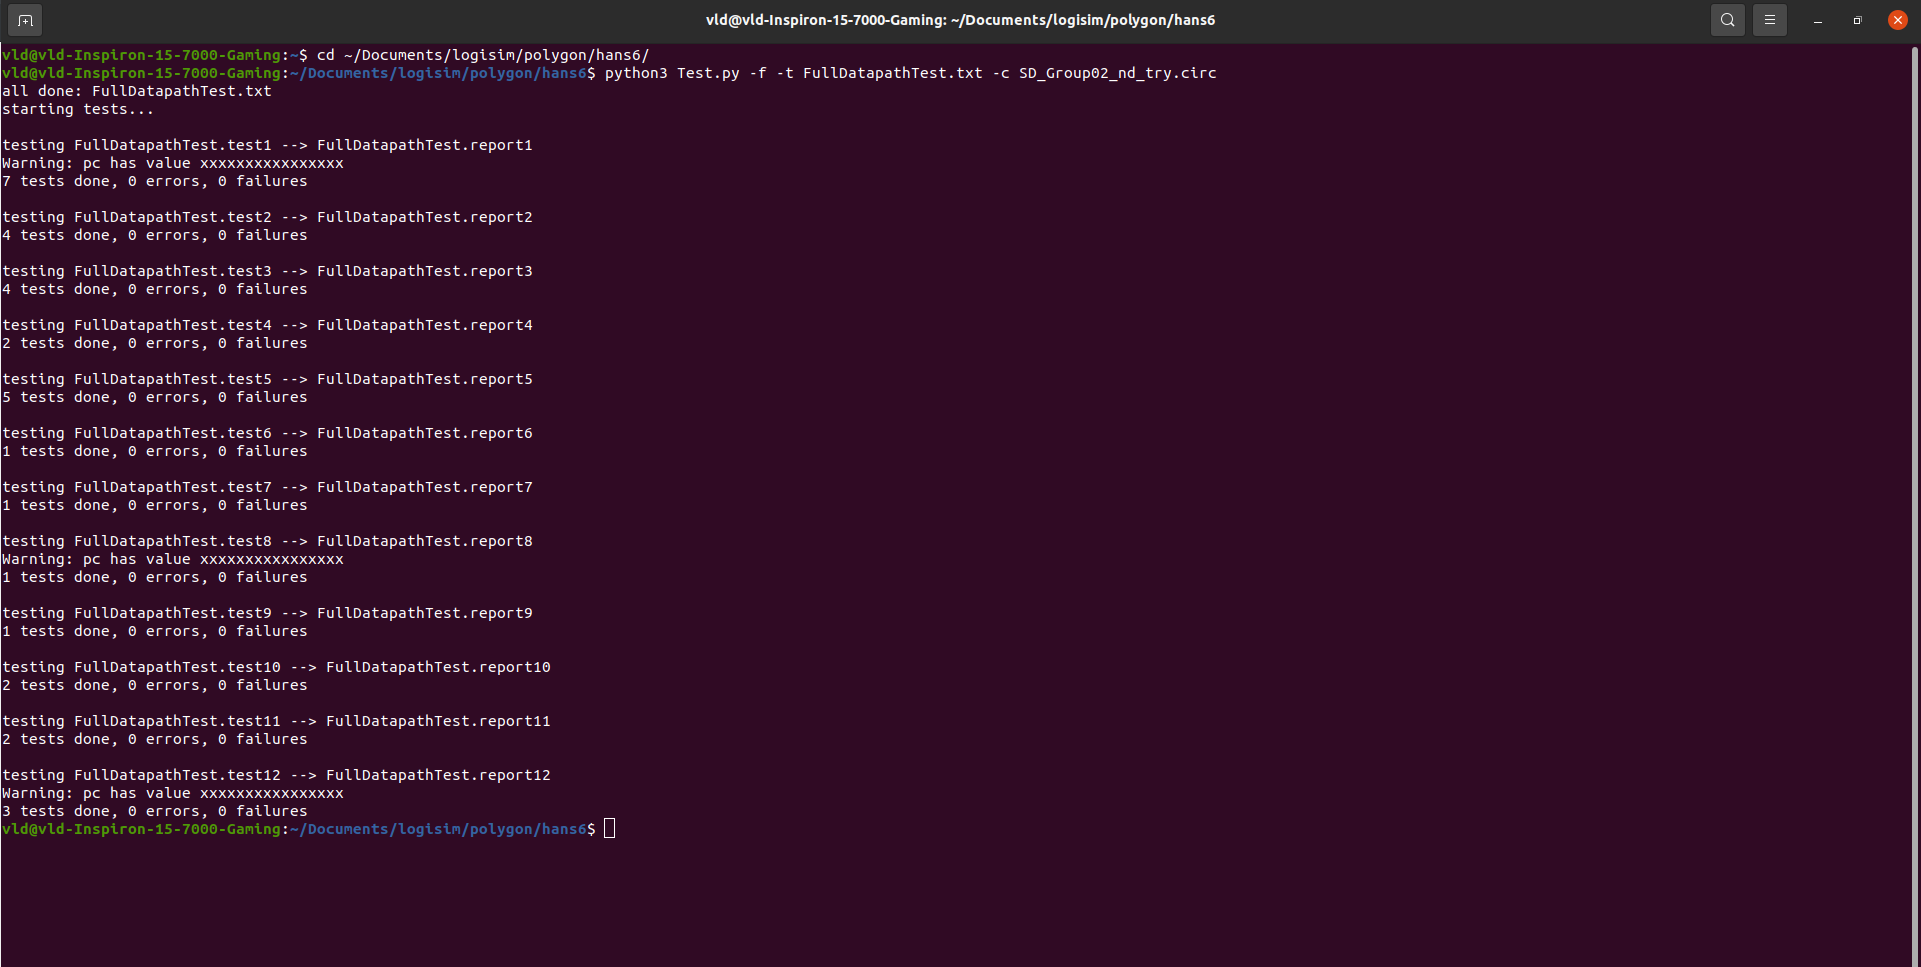
Alles werkt perfect (niet van der eerste keer natuurlijk) met een paar warnings wat ons niet echt stoort.
Wat hebben we in deze project dus geimplementeerd? We hebben hier een volledige datapath geimplementeerd die behalve de bewerkingen met ALU en interactie met een aparte RAM geheugen, nu ook sprongen kan maken in onze programma en waarden kan krijgen uit de instructie rechtstreeks zonder de preset ervan.
Project 7: Datapath in use
Nu hebben we een volledig werkende datapath, maar we missen wel een foutendetectie. We hebben namelijk 2 problemen die in onze datapath zouden kunnen optreden. Eerste probleem is wanneer de instructie op een foute manier wordt doorgegeven. We hebben namelijk combinaties die niet zijn gedefinieerd in onze instructieset en als gevolg niet zijn geimplementeerd in onze datapath. De resultaat van deze fout is niet voorspeelbaar. Tweede probleem ligt bij onze ALU. Omdat onze ALU enkel met 16 bit getallen kan werken, kan die een overflow hebben als de resultaat van een bewerking niet in de werkdomein ervan valt. Dit zal ons dan rekenfouten opleveren wat ook tot onvoorspelbare resultaten kan leiden. Enige manier om deze fouten(exceptions) op te vangen, is om de uitvoer van onze programma te stoppen.
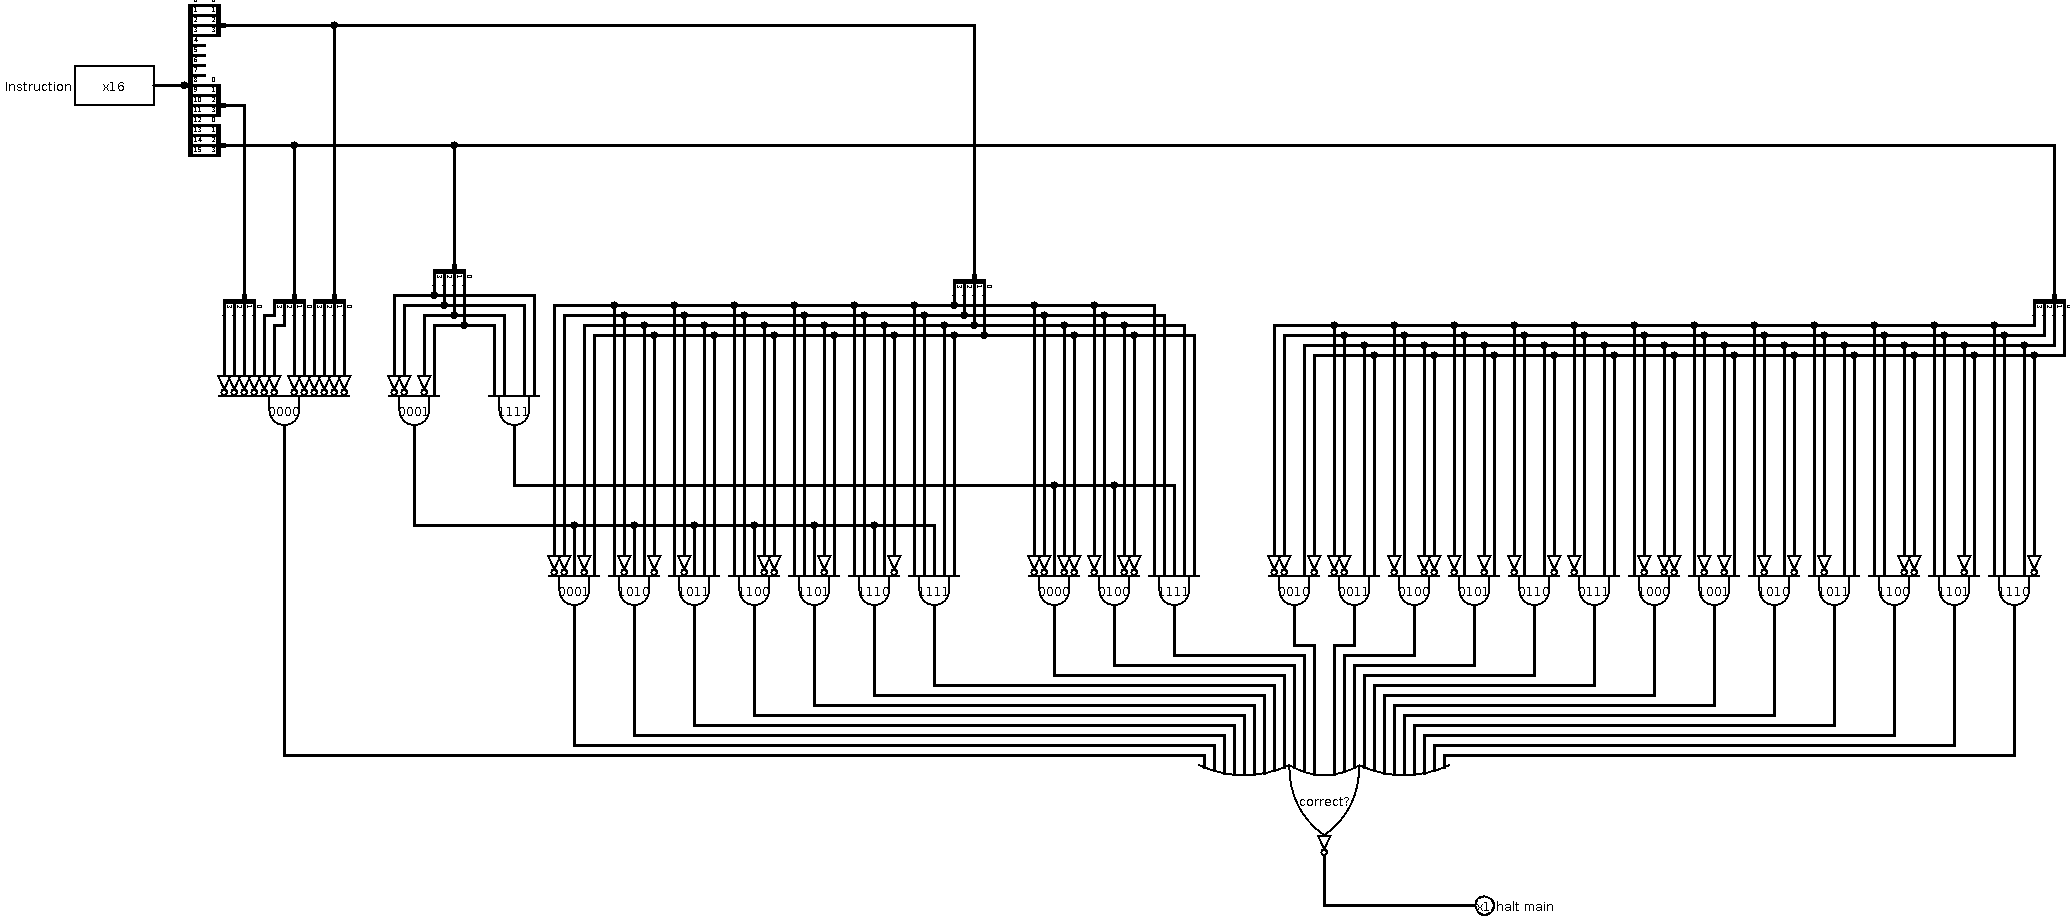
De overflow kunnen we al detecteteren met onze ALU, daarvoor hebben we een aparte output al geimplementeerd in project 3. Om de foute instructiecombinatie te kunnen detecteren, voegen we nog een aparte circuits toe die de instrcutie analyseert. We gaan zich hiervoor baseren op de decoder uit project 1. We weten dat de opcode (15-12 bits) uit 4 bits bestaan en alle 24=16 geldige opcodes zijn. Nu kunnen we uit onze instructietabel volgende volgende opcodes halen met bijkomende functiewaarde: 0000 , 0001 , 1111 . We zien deze waarden in de volgende tabel.
Spoiler: Exception schema
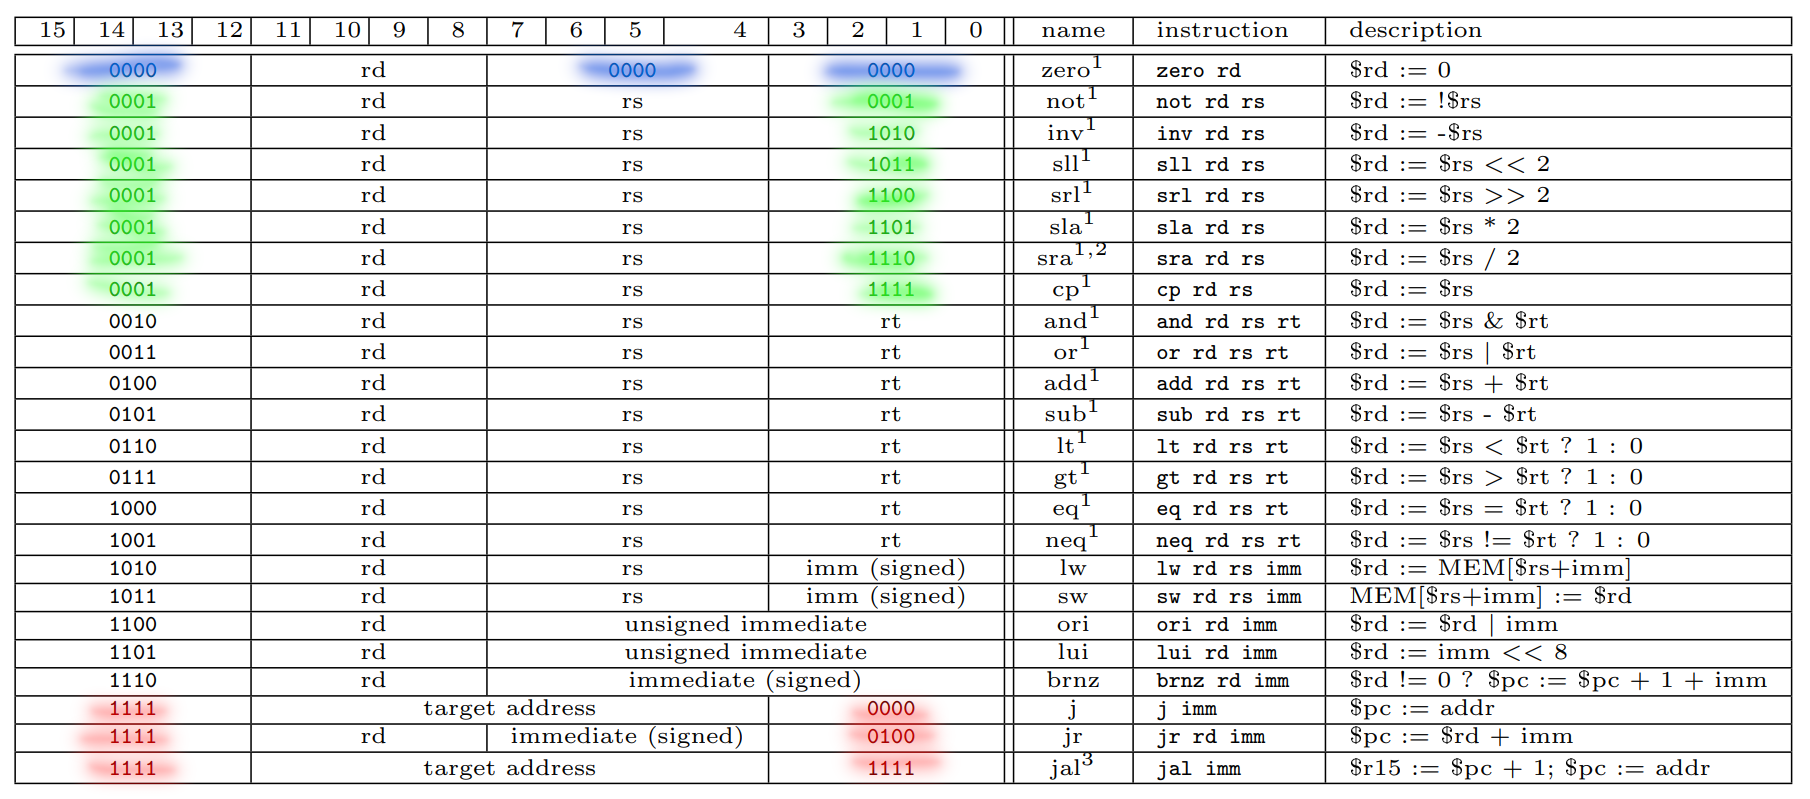
We gaan beginnen met de opcode 0000. Hier moeten de functiewaarden (7-0 bits) 0000 0000 . Hiervoor gaan we dus 1 AND nodig hebben om deze instructie te controleren.
Voor alle andere opcodes gaan we 15 AND poorten maken met 4 inputs. We halen de AND poorten die de opcodes 0001 en 1111 detecteren. Voor opcode 0001 zijn er 8 mogelijke functiewaarden die een correcte instructie vormen. We gaan dus 8 AND poorten plaatsen voor alle mogelijke functiewaarde en telkens in combinatie met de output van AND 0001. Met zelfde principe kunnen we de opcode 1111 combineren met zijn 3 correcte functiewaarden.
We hebben nu alle mogelijke situaties gecontroleerd waanneer de instructies correct zijn en wanneer er geen halt moet worden opgeroepen. We weten dat er altijd juist 1 finale AND een 1 zal geven als alles correct verloopt. Om deze reden plaatsen we een grote OR poort en erachter direct en NOT (of met andere woorden gewoon 1 grote NOR poort). Onze exception unit zit er als volgt uit:
Spoiler: Exception schema
We kunnen besluiten dat als een overflow OF foute instructie optreedt, geven we een signaal door aan halt. We verbinden output van exception en overflow met een OR en geven we de output ervan aan de halt via een of poort. Onze uiteindelijke schema zit er als volgt uit.
Spoiler: Exception schema
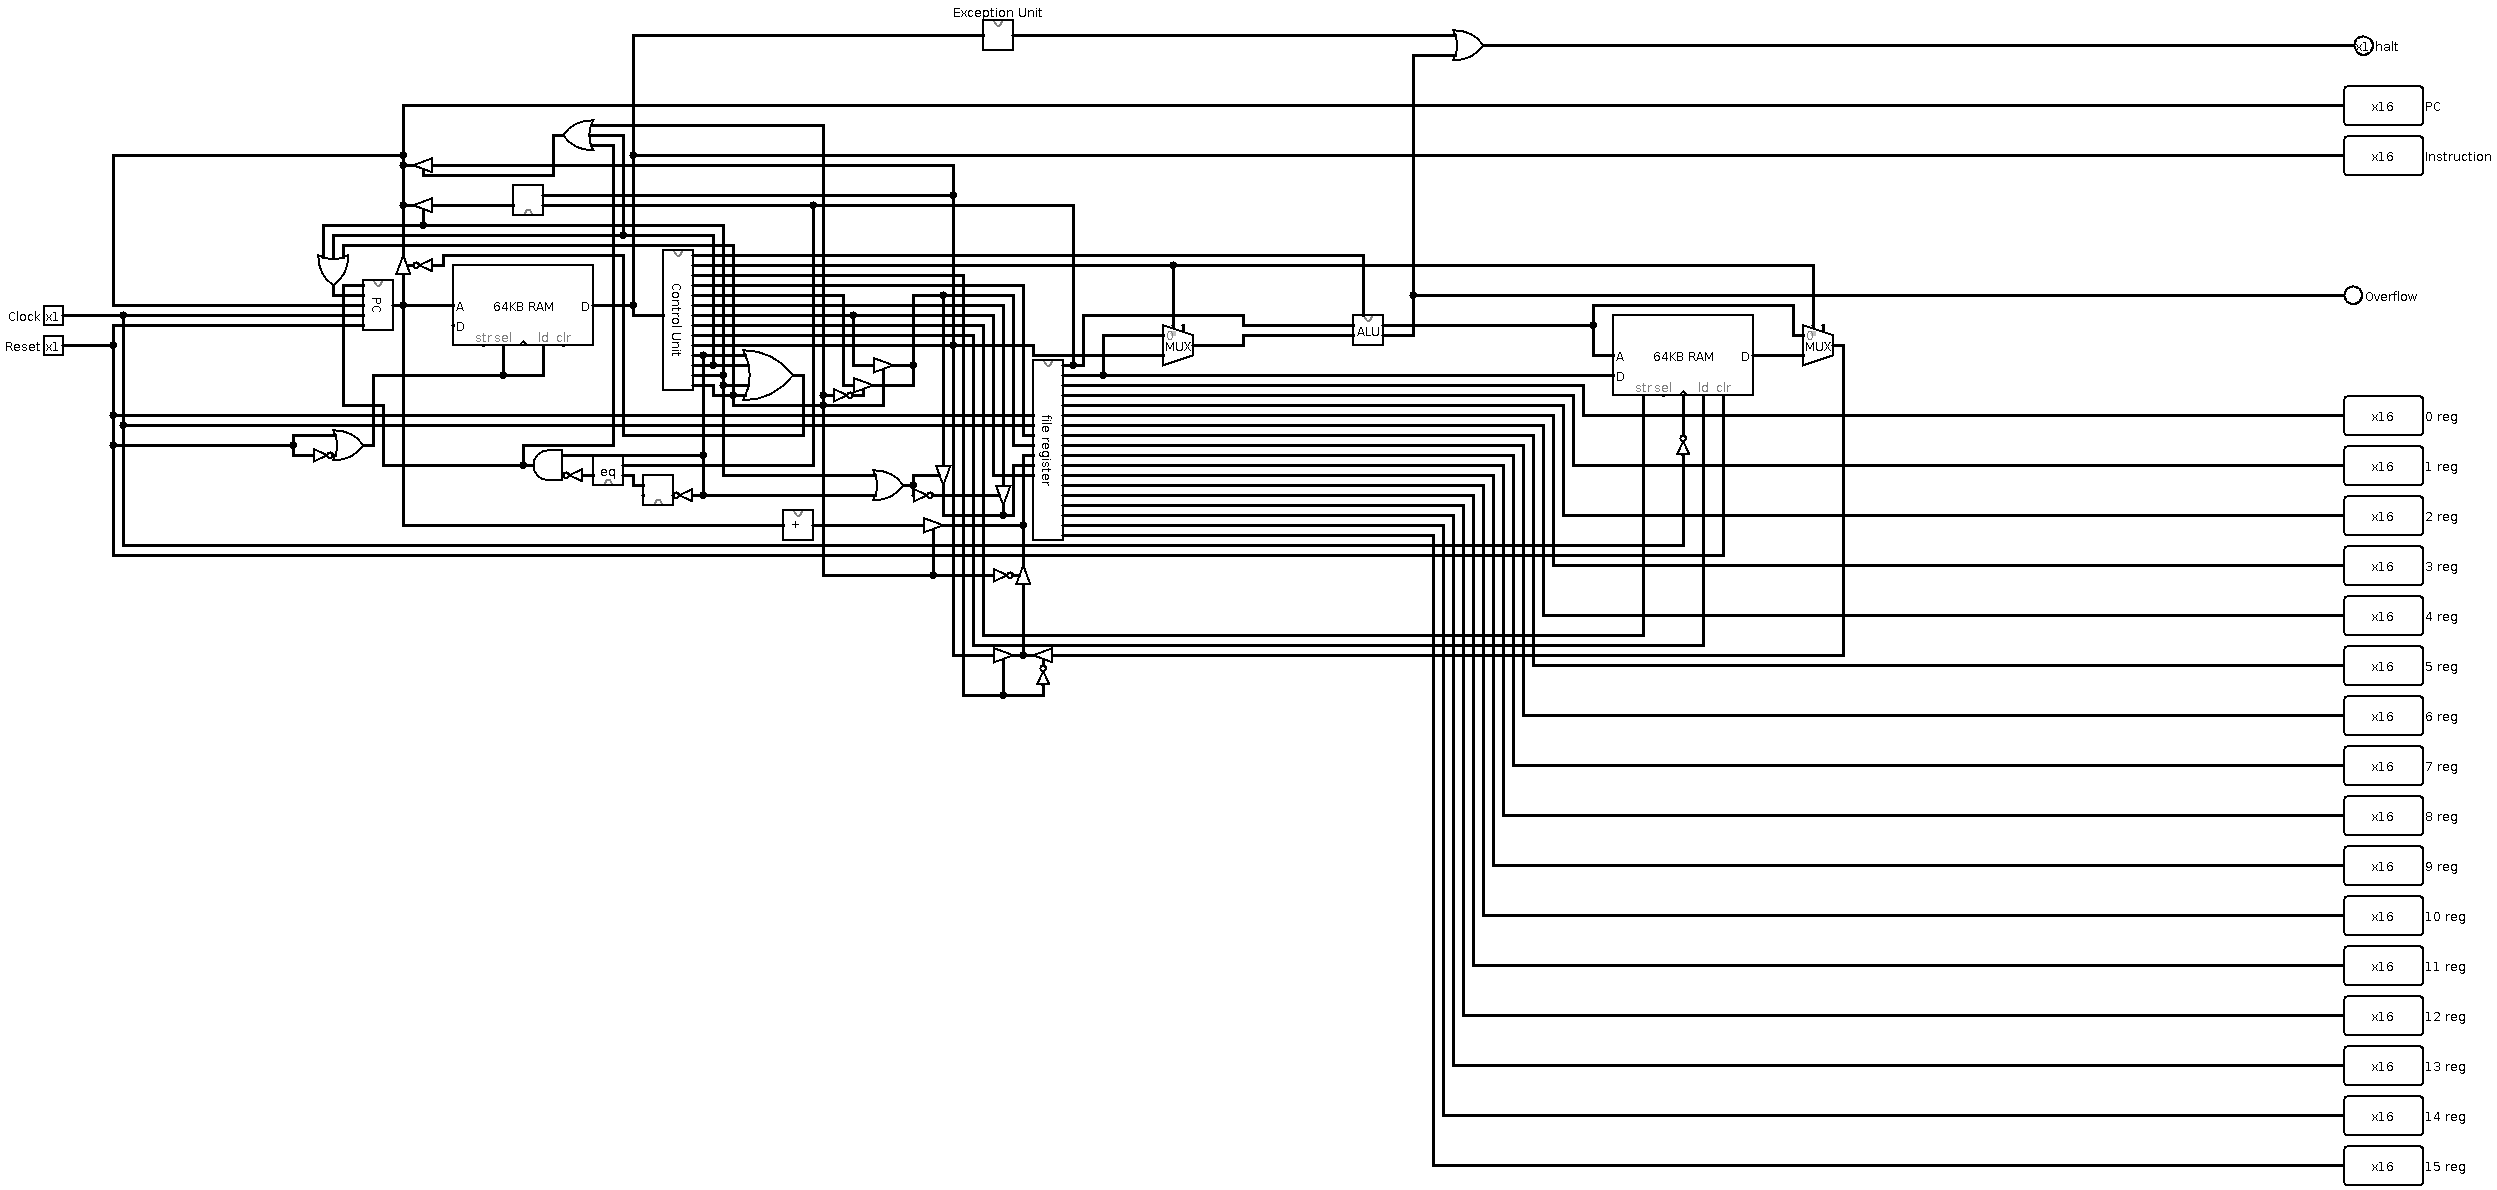
De halt element werd minimaal aangepast en is niet interessant om te bekijken.
Om te tonen dat onze datapath wel iets kan berekenen hebben we een aparte testfile gemaakt. Bij fibonacci getallen stopt onze programma door de overflow bij 28657. De volgende nummer past niet meer in 16 bit (2's complement), want (46368)10 = (0 1011 0101 0010 0000)2.
Onze tweede programma was een sorteerslgoritme, maar die is niet volledig afgeraakt. Het sorteren zou moeten werken, maar de invoer van de getallen en exit was niet volledig afgeraakt.
Algemeen besluit van onze 7 projecten
In begin van onze project hadden we enkel de 3 logische poorten die we al langer kenden uit discrete wiskunde (2 studenten wiskunde hebben hier gewerkt). Uiteindelijk hebben we een volwaardige datapath uitgewerkt waarbij alle elementen(behalve D-flipflop en RAM) minstens 1 keer volledig door ons handmatig werden opgebouwd. Onze datapath is in staat om berekeningen te doen, te werken met geheugen en fouten in programma en berekeningen herkennen en de hele systeem daardoor laten stoppen.
Bij deze projecten was het belangerijk om zoveel mogelijk processen te proberen veralgemenen om de opbouw van onze systeem te veersnellen. Hier eindigt onze project van datapath die enkele maanden heeft geduurt.